L’automatisation documentaire par l’IA consiste à transformer des documents en informations exploitables pour classer, extraire, vérifier et préparer des décisions métier. Son intérêt dépend du travail réellement évité et de la qualité conservée. Avant de choisir un outil, il faut préciser ce qui doit sortir du traitement, comment le vérifier et qui reprend les exceptions.
Quelles tâches documentaires peut-on automatiser en entreprise ?
L’automatisation documentaire peut préparer le classement, la saisie, les contrôles et les synthèses, à condition de définir précisément le résultat attendu et les exceptions.
Le classement oriente une pièce vers une catégorie ou un circuit de traitement. L’extraction renseigne des champs définis : référence, date, montant, interlocuteur. Le contrôle de cohérence rapproche ces valeurs de règles explicites ou d’autres documents. La synthèse prépare une lecture rapide, avec les passages qui justifient ses conclusions. Chaque tâche appelle un contrôle distinct.
Commencez par décrire le travail actuel : documents reçus, ressaisies, recherches, vérifications et décisions. Une pièce bien classée peut contenir un montant mal extrait ; un résumé fluide peut omettre une réserve importante. L’évaluation doit donc porter sur le résultat attendu à chaque étape.
Pour identifier un cas d’usage IA rentable, examinez aussi la fréquence des exceptions et le coût de leur correction. Définissez les actions que l’outil peut préparer et celles qui exigent une autorisation.
Quelle différence entre OCR, extraction structurée et compréhension ?
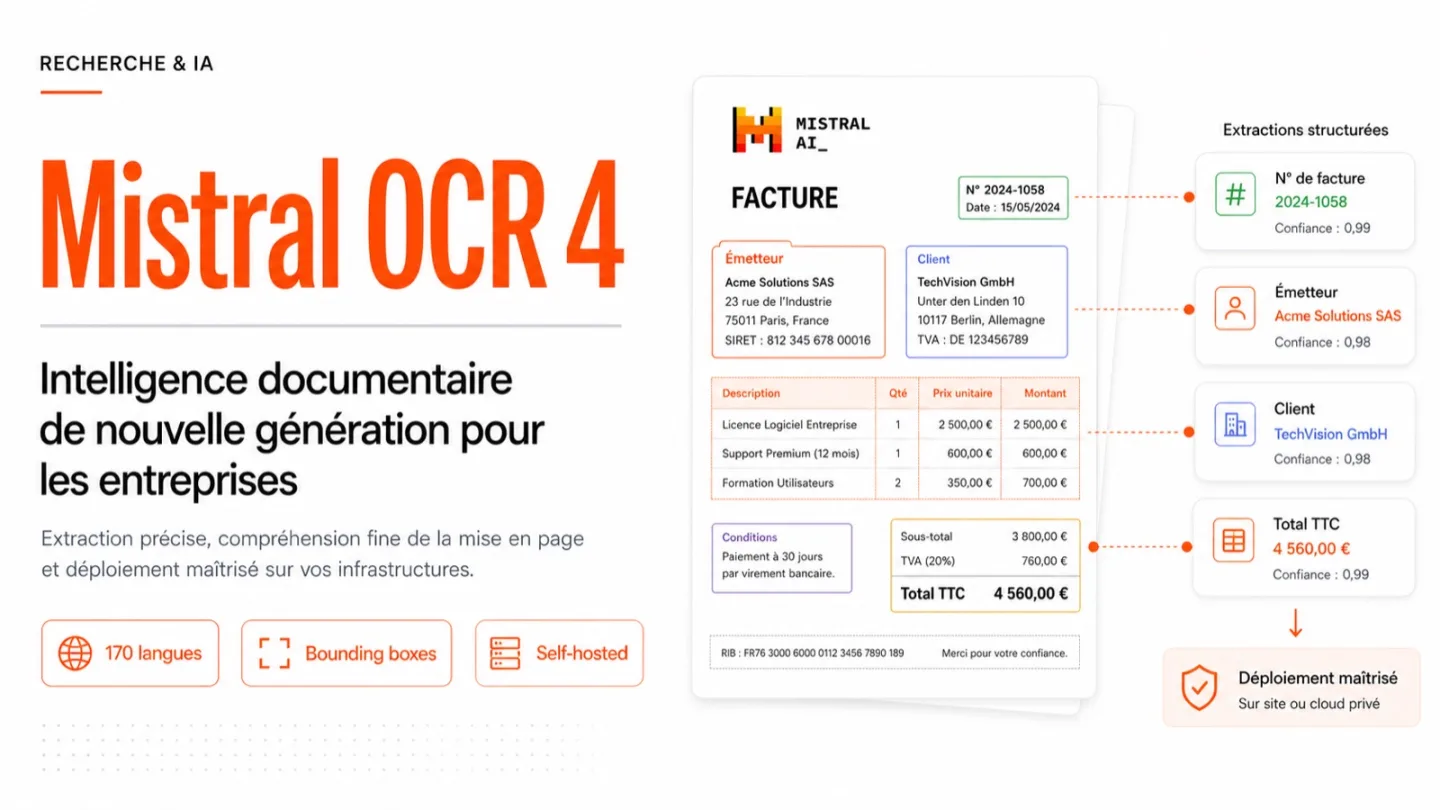
L’OCR reconnaît le texte, l’extraction structurée associe des valeurs à des champs définis, tandis que la compréhension interprète des relations et des consignes métier.
L’OCR, ou reconnaissance optique de caractères, transforme une image en texte exploitable. L’analyse de mise en page peut également restituer lignes, cellules et positions. La documentation Microsoft sur la lecture documentaire distingue ces éléments, dont la reconnaissance du manuscrit dans les langues prises en charge.
| Niveau | Résultat attendu | Vérification à prévoir |
|---|---|---|
| OCR et mise en page | Texte, cellules, positions | Fidélité au document original |
| Extraction structurée | Valeurs dans des champs définis | Valeur, type et rattachement corrects |
| Compréhension documentaire | Relations, explications, synthèse | Justification par les passages sources |
La documentation des annotations Mistral décrit une extraction au format JSON fourni par l’utilisateur, ajoutée à l’OCR. Notre article consacré à Mistral OCR présente un exemple d’outil. Un schéma valide organise la réponse ; il ne démontre pas que les valeurs sont exactes.
La compréhension désigne ici une interprétation utile au métier, comme rapprocher une clause et son exception. Demandez une justification localisable et une possibilité d’abstention lorsque le document ne permet pas de conclure.
Comment organiser une chaîne documentaire fiable ?
Une chaîne documentaire fiable sépare la réception, la lecture, l’extraction, les contrôles et la validation, avec un responsable identifié pour chaque anomalie rencontrée.
Définissez les champs avant de configurer le modèle. Pour chacun, précisez sa signification, son type, les formats acceptés et le traitement des absences. Distinguez une information manquante, une zone illisible et une information contradictoire.
- Réceptionner les fichiers, attribuer un identifiant et repérer les doublons.
- Identifier la famille documentaire et vérifier que le fichier est exploitable.
- Lire le contenu en conservant le lien vers la page ou la zone source.
- Extraire les champs et appliquer les règles de normalisation convenues.
- Contrôler formats, rapprochements et incohérences, puis orienter les exceptions vers une personne.
- Valider les résultats autorisés, tracer leur destination et conserver les éléments nécessaires au contrôle.
Cette séquence est une méthode proposée, à adapter au processus. Gardez la version du modèle, du schéma et des règles afin de reproduire une erreur. Le principe du registre de preuves en production aide à relier document, proposition, correction et décision finale.
Comment mesurer la précision par champ et le rappel ?
La qualité d’une extraction documentaire se mesure séparément pour chaque champ, en comparant les valeurs produites aux valeurs attendues dans un corpus annoté.
La précision par champ est le nombre d’occurrences correctement extraites divisé par toutes les occurrences produites pour ce champ. Le rappel, ou recall, est le nombre d’occurrences correctement extraites divisé par toutes les occurrences attendues pour ce champ dans la référence. Une valeur erronée peut compter à la fois comme prédiction incorrecte et valeur attendue manquante. Ces définitions suivent la méthode d’évaluation de Google Document AI.
Préparez une référence relue humainement, indépendante des documents utilisés pour régler le système. Fixez les règles de correspondance : format des dates, séparateurs décimaux, espaces et identification des lignes répétées. Une valeur doit appartenir au bon champ du bon document et, pour un tableau, à la bonne ligne. Si un dénominateur est nul, indiquez que le taux est non calculable.
Publiez les effectifs avec les taux, puis détaillez les résultats par famille documentaire et champ critique. Suivez aussi les documents entièrement corrects parmi les documents évalués. Pour les synthèses, examinez séparément exactitude, omissions et justification des affirmations, selon la démarche proposée pour auditer une réponse générée par IA.
Où placer la validation humaine et comment mesurer la reprise ?
La validation humaine intervient avant les actions engageantes et sur les exceptions, tandis que son volume se mesure avec un périmètre et une unité explicites.
Placez une validation avant un paiement, un envoi externe ou une modification importante d’un dossier. Prévoyez une file pour les champs manquants, les contradictions et les formats inconnus. Le contrôleur doit voir la proposition à côté du passage source, pouvoir corriger ou refuser et connaître la conséquence de sa validation.
Distinguez revue et reprise. Le taux de revue rapporte les documents effectivement relus au total des documents entrants du périmètre. Le taux de reprise humaine observé rapporte les documents corrigés ou complétés humainement au même total, sur la même période. Comptez chaque document une seule fois et affichez séparément les rejets et échecs, sans les retirer silencieusement du dénominateur. Ces indicateurs mesurent la charge constatée, pas les erreurs non détectées.
Si seule une partie du flux est relue, publiez aussi les documents corrigés divisés par les documents effectivement relus, sans extrapoler ce résultat au flux entier. Contrôlez un échantillon représentatif des sorties acceptées pour rechercher les erreurs restantes. Traitez le score de confiance comme un signal de tri à vérifier sur le corpus.
Quels pièges prévoir avec les tableaux, le manuscrit et les formats hétérogènes ?
Les formats hétérogènes, les tableaux complexes et le manuscrit doivent être évalués séparément, car reconnaître des mots ne démontre pas la fidélité d’un document entier.
Constituez des lots représentatifs : PDF natifs, scans, photographies, documents multilingues et versions de formulaires différentes. Ajoutez les cas difficiles réellement reçus : pages inclinées, contrastes faibles, pièces incomplètes et annotations. Conservez les résultats par sous-ensemble pour repérer les limites masquées par une moyenne globale.
Pour les tableaux, contrôlez les associations entre en-têtes, lignes, cellules fusionnées et unités. Microsoft documente notamment les indices de lignes et colonnes ainsi que les positions des cellules dans son analyse de mise en page. Testez les changements de page et les sous-totaux : une valeur reconnue au mauvais emplacement reste incorrecte.
Pour le manuscrit, prévoyez un statut illisible et une reprise adaptée. Une signature détectée ne doit pas être interprétée comme une validation authentifiée. Lorsqu’une information manque, demandez une absence explicite plutôt qu’une valeur supposée.
Comment protéger les données personnelles dans les documents ?
La protection des données documentaires commence avant leur transmission, en définissant les informations autorisées, les accès nécessaires et les conditions de conservation chez chaque prestataire.
Les pièces peuvent contenir identités, coordonnées ou informations confidentielles dans le texte, les images et les annexes. La CNIL recommande de cadrer les usages et le déploiement, d’examiner la réutilisation possible des données par le prestataire et d’impliquer les responsables métier, informatique, sécurité et protection des données.
Avant un essai, déterminez quelles données sont nécessaires et quel environnement est autorisé. Vérifiez les accès, l’hébergement, les sous-traitants, la conservation, la suppression et les conditions d’utilisation pour entraîner les modèles. Incluez les fichiers temporaires, les journaux et les résultats extraits dans cette analyse.
Appliquez les mêmes restrictions aux documents sources et aux synthèses qui en dérivent. Les pratiques pour prévenir les fuites de données avec l’IA complètent ce cadrage. Un hébergement interne demande lui aussi des règles d’accès, de sauvegarde et de purge.
Comment passer du pilote à un usage durable ?
Un pilote documentaire devient exploitable lorsque son périmètre, ses critères d’acceptation et son organisation de reprise sont documentés puis vérifiés sur des documents réellement représentatifs.
Choisissez une famille de documents et un résultat mesurable. Fixez les critères par champ selon les conséquences d’une erreur, puis comparez le processus assisté au travail actuel : temps de contrôle, corrections, délais et coût complet. Incluez l’outillage, l’intégration, la supervision et les reprises.
Prévoyez une nouvelle évaluation lors des changements de modèle, de schéma ou de document. Désignez qui peut suspendre le traitement et comment revenir à une gestion manuelle. Pour éviter les échecs des pilotes IA, commencez par un flux limité, contrôlable et utile avant d’élargir son autonomie.
Questions fréquentes
Ces réponses complètent la méthode de déploiement en précisant les choix d’outillage, les limites de l’extraction et les conditions d’un contrôle humain utile.
Faut-il un modèle génératif pour tous les documents ?
Non. Commencez par comparer les solutions avec les mêmes résultats attendus. Un texte déjà disponible peut être exploité directement ; un formulaire stable peut être traité avec des règles. Réservez l’interprétation générative aux tâches qui la justifient et mesurez son apport sur votre corpus.
Un JSON valide suffit-il pour intégrer les données ?
Non. La validité du JSON garantit une structure lisible par le logiciel. Vérifiez également les types, les valeurs autorisées, les références et la fidélité au document. Une date correctement formatée peut être la mauvaise date ; un montant numérique peut correspondre à une autre ligne.
Comment choisir un seuil de confiance ?
Testez plusieurs seuils sur un corpus annoté, puis observez les erreurs acceptées et les documents orientés vers la revue. Fixez la règle selon le champ et ses conséquences métier. Confirmez ensuite son comportement sur un lot indépendant avant de l’appliquer au flux courant.
Peut-on traiter un dossier composé de plusieurs pièces ?
Oui, mais prévoyez un identifiant de dossier et conservez la provenance de chaque information. Définissez comment gérer les versions, les doublons et les contradictions entre pièces. Testez aussi les dossiers incomplets : l’absence d’une annexe doit apparaître explicitement au lieu d’être compensée par une supposition.
Comment savoir si l’automatisation fait gagner du temps ?
Comparez le temps consacré à des lots comparables avant et après assistance. Incluez préparation, contrôle, correction et traitement des exceptions. Présentez les volumes et les familles documentaires observés. Une extraction rapide peut déplacer le travail vers la vérification ; le bilan doit couvrir le processus complet.
Sources
Les sources primaires suivantes décrivent les capacités documentaires, les méthodes d’évaluation et les précautions de déploiement qui fondent les recommandations opérationnelles de cet article.