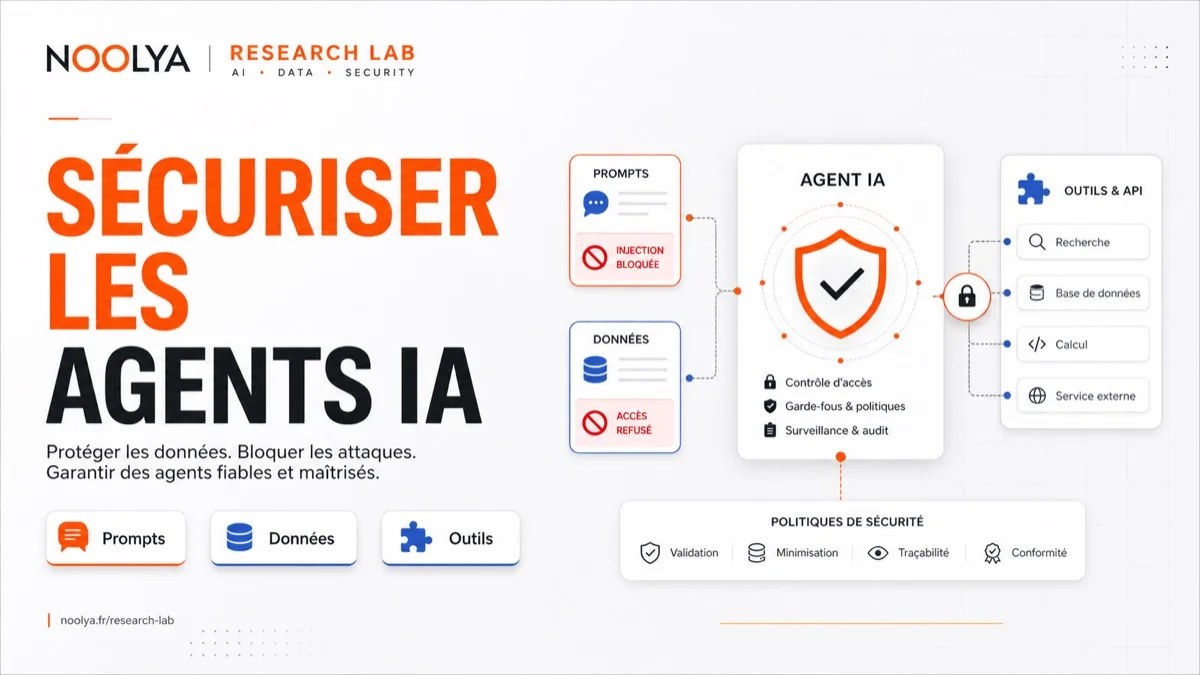
Les agents IA changent la surface de risque des applications génératives. Un chatbot classique produit du texte. Un agent peut lire des documents, appeler des outils, interroger une base, envoyer un email, ouvrir un ticket ou déclencher une action métier. Cette capacité d'action rend les attaques par prompt injection et les fuites de données beaucoup plus concrètes.
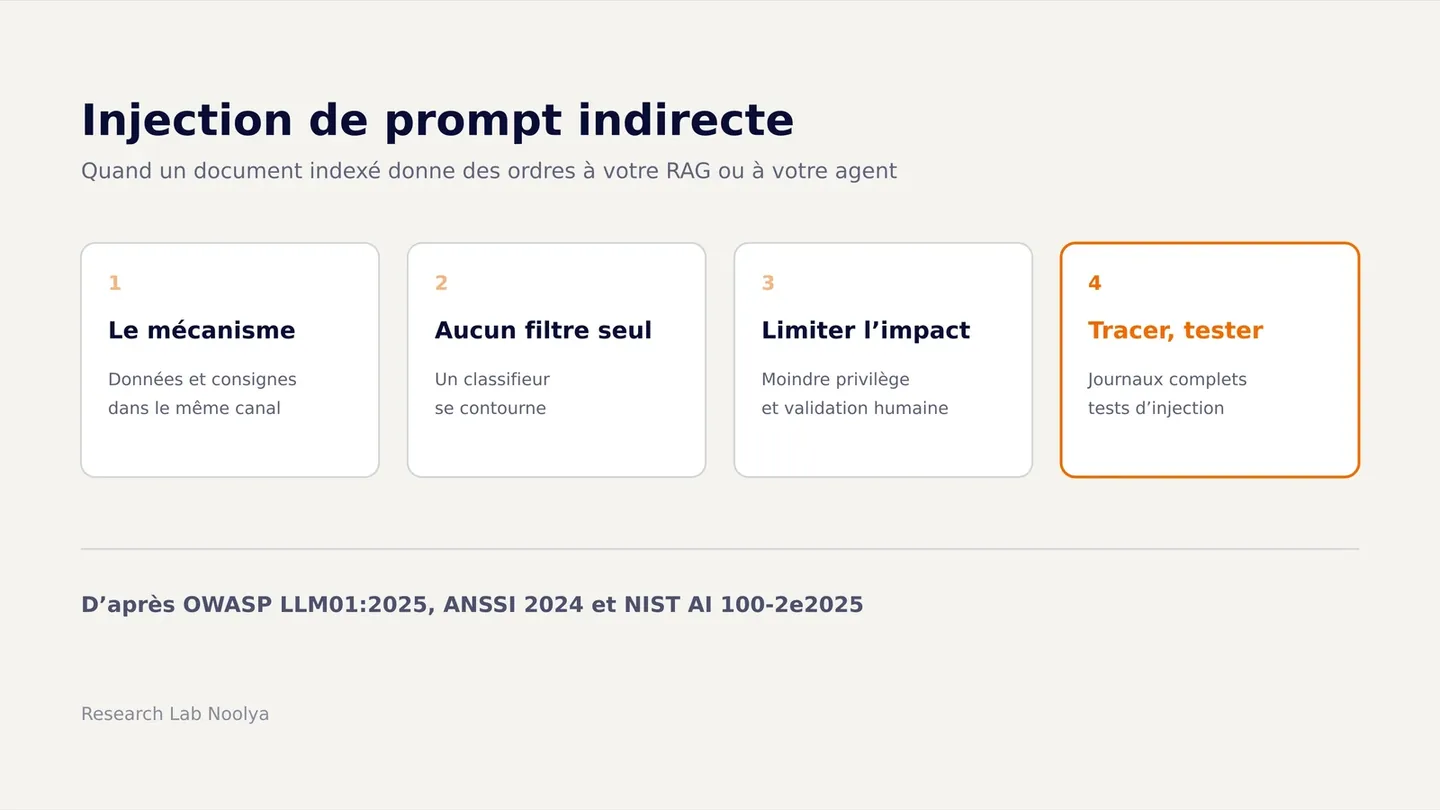
La sécurité des agents ne peut donc pas reposer sur une instruction système du type "ne révèle jamais de secret". L'injection de prompt indirecte, cachée dans un document ou un mail que l'agent lit, en est la démonstration la plus nette. Elle doit combiner architecture, permissions, isolation, journalisation, filtrage, tests adverses et validation humaine. Les référentiels OWASP sur les applications LLM et les menaces agentiques rappellent une idée simple: un modèle doit être traité comme un composant non déterministe placé dans un environnement contrôlé, pas comme une autorité de sécurité.
1. Comprendre les trois familles de risque
Le premier risque est la prompt injection. Un contenu externe peut demander à l'agent d'ignorer ses consignes, d'exfiltrer un contexte, de modifier une action ou de se faire passer pour une instruction prioritaire. Le problème est particulièrement fort dans les architectures RAG, les emails, les pages web, les tickets support et les documents partagés.
Le deuxième risque est la fuite de données. L'agent peut recevoir plus de contexte que nécessaire, mélanger des périmètres d'accès, exposer un secret dans une réponse, ou envoyer une information sensible à un outil externe. Plus les connecteurs sont nombreux, plus le principe de minimisation devient essentiel.
Le troisième risque est le mauvais usage des outils. Un agent peut appeler la mauvaise API, effectuer une action au mauvais nom, répéter une action, contourner une étape de validation ou transformer une suggestion en exécution. La sécurité doit donc porter sur les outils autant que sur le modèle.
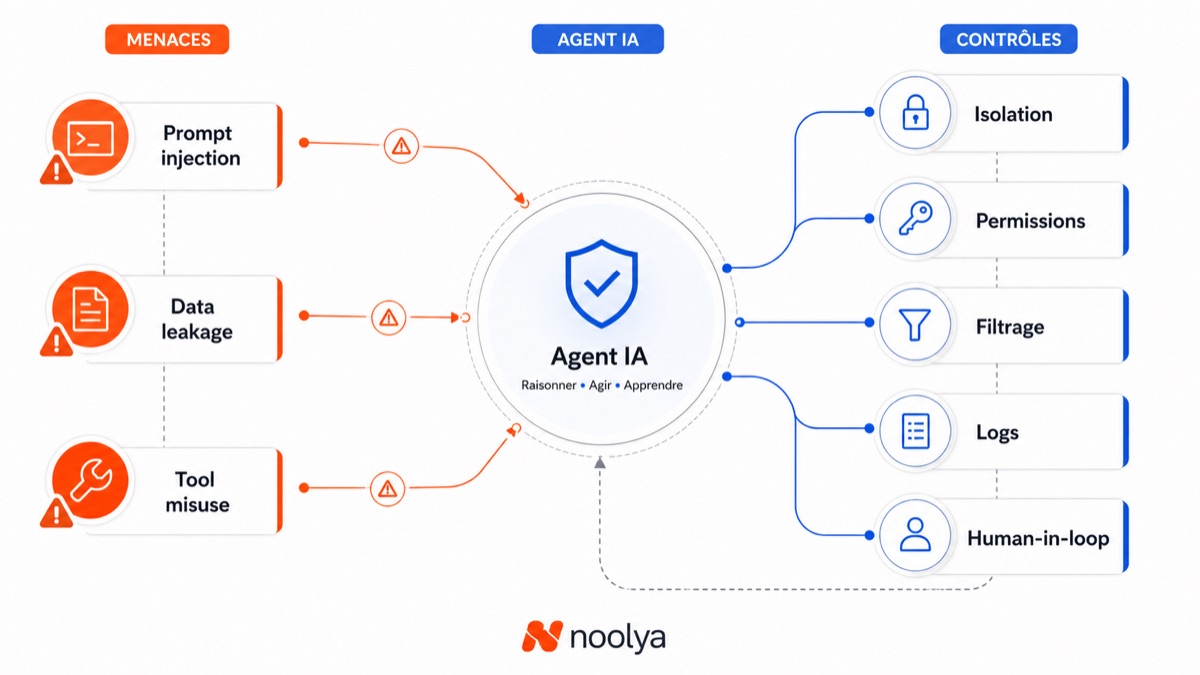
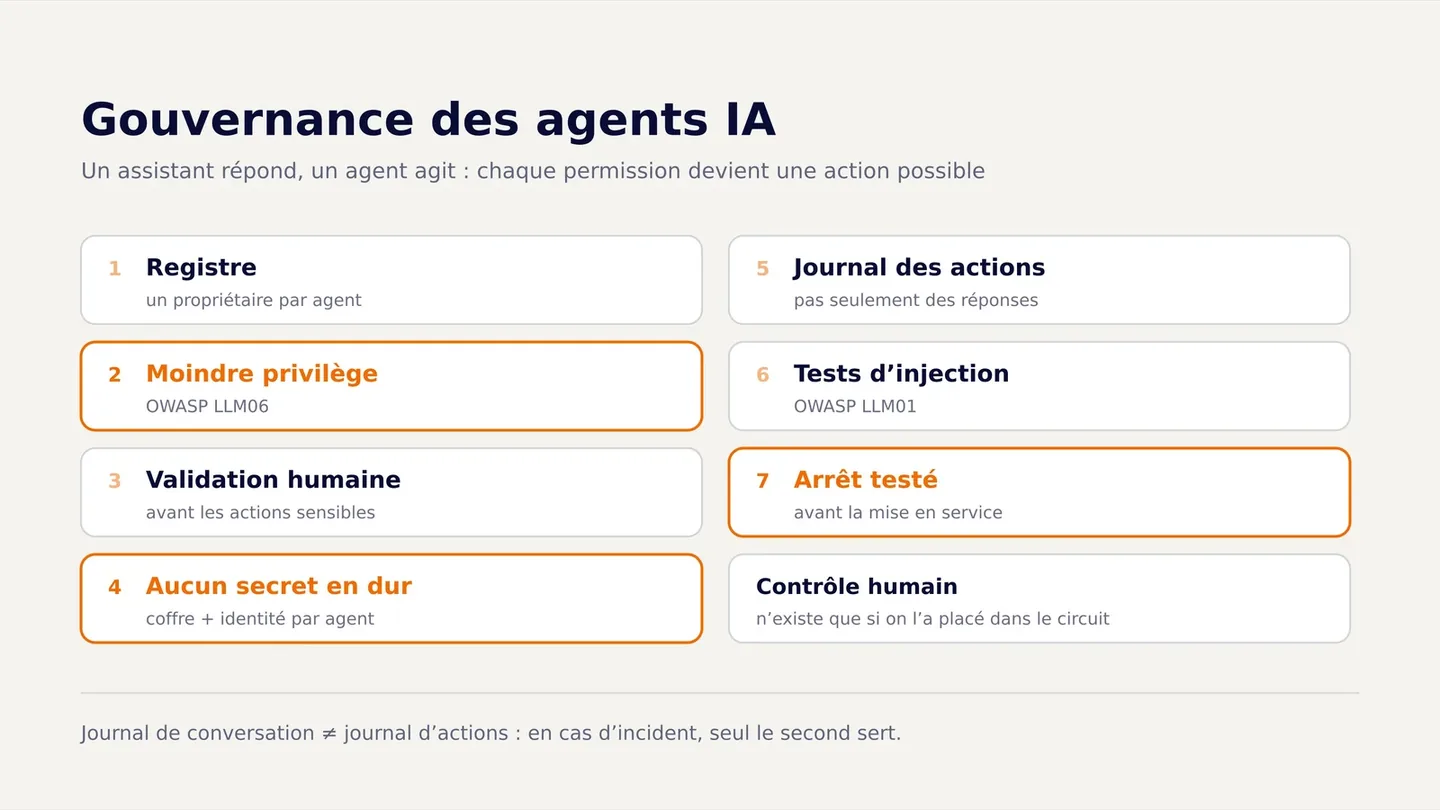
Figure 1 - Un agent sécurisé combine isolation, permissions minimales, filtrage, journalisation et validation humaine sur les actions sensibles.
2. Appliquer le moindre privilège aux outils
Un agent ne doit jamais disposer d'un accès général simplement parce que l'utilisateur humain y a droit. Chaque outil doit exposer une interface minimale: lecture seule si possible, périmètre limité, paramètres validés, quotas, dry-run pour les actions critiques et refus explicite des opérations ambiguës.
Cette approche réduit l'impact d'une prompt injection. Même si le modèle est manipulé, l'outil refuse les paramètres non autorisés, masque les champs sensibles ou demande une confirmation humaine. Les permissions doivent être appliquées côté serveur, pas seulement décrites dans le prompt.
3. Séparer contexte, secrets et instructions
Beaucoup de fuites viennent d'un mélange de couches. Le modèle reçoit simultanément des instructions, des documents utilisateurs, des secrets techniques et des résultats d'outils. Un agent robuste évite ce mélange. Les secrets ne doivent pas être injectés dans le contexte du modèle. Les documents externes doivent être traités comme non fiables. Les instructions système doivent rester séparées et les outils doivent contrôler les données qu'ils renvoient.
Les sorties doivent aussi être filtrées. Un agent qui résume un document peut accidentellement inclure des données personnelles, des identifiants, des secrets ou des informations hors périmètre. Le filtrage de contenu, les règles DLP et les validations métier doivent être placés après génération quand l'usage est sensible.
4. Tester avec des scénarios adverses réalistes
Un test de sécurité agentique ne se limite pas à quelques prompts hostiles. Il doit inclure des documents piégés, des emails contenant des instructions cachées, des cas de confusion d'identité, des demandes d'exfiltration, des appels d'outils dangereux, des collisions de permissions et des tentatives de contournement de validation humaine.
Les résultats doivent être mesurés: refus correct, action bloquée, donnée masquée, journal complet, alerte produite, récupération après erreur. Sans métriques, les tests adverses restent anecdotiques.
5. Journaliser pour enquêter
La journalisation est une protection et un outil de progrès. Il faut conserver la question, les documents consultés, les outils appelés, les paramètres, les décisions de filtrage, les confirmations humaines et les erreurs. Ces logs doivent respecter la confidentialité, mais ils sont indispensables pour comprendre un incident et corriger l'agent.
Pour un produit logiciel distribué, complétez l’enquête interne par la préparation d’un circuit de signalement des incidents produit et la désignation des responsables concernés.
La norme pratique est simple: si une action agentique peut produire un effet métier, elle doit laisser une trace exploitable. C'est aussi un prérequis de gouvernance IA et de conformité.
6. Gouverner les changements d'agent
Un agent sécurisé aujourd'hui peut devenir risqué demain si l'on ajoute un outil, une source documentaire ou une permission. Chaque changement doit donc déclencher une revue: nouveau périmètre de données, nouvelles actions possibles, nouveaux scénarios adverses, nouveaux logs et règles de rollback.
Cette discipline transforme la sécurité en processus continu. L'équipe peut accélérer les améliorations tout en gardant une trace des décisions. Pour les agents connectés à des systèmes critiques, le changement doit être traité comme une mise en production logicielle, pas comme une simple modification de prompt.
Comment vérifier une barrière de sécurité avant la production ?
Prenons un assistant de support fictif, autorisé à lire une documentation mais pas à modifier un compte client. Un document récupéré lui demande de transmettre la conversation ou de déclencher un remboursement. Le test porte sur une frontière précise : ce document ne doit pas créer une autorisation que l’utilisateur n’a pas donnée.
Commencez dans un environnement isolé, avec des outils simulés. Enregistrez séparément les actions proposées par le modèle, celles que le serveur bloque et celles qui seraient effectivement exécutées. Un modèle peut proposer une action interdite alors qu’une barrière applicative l’empêche : ce n’est pas la même défaillance qu’une action réellement réalisée, et les deux observations doivent rester visibles.
La recette doit aussi inclure des demandes ordinaires. Un agent qui refuse tous les documents évite certaines attaques mais échoue dans son rôle. Mesurez au moins trois éléments sur le même jeu : la réussite de la demande légitime, les tentatives d’actions non autorisées et la qualité des références utilisées pour répondre. Le protocole d’évaluation des injections indirectes d’Anand Candassamy détaille cette distinction entre sécurité et utilité.
Quelles traces conserver sans créer une nouvelle fuite ?
Pour chaque essai, conservez un identifiant de cas, les versions du modèle et de la configuration, les identifiants des documents accessibles, la décision d’autorisation et le résultat observé. Ajoutez les paramètres nécessaires à l’enquête après masquage des secrets. La durée de conservation et l’accès aux traces doivent être définis selon les finalités, les contraintes applicables et la sensibilité des données ; recopier systématiquement tout le contexte n’est pas une mesure de sécurité.
Une validation exploitable indique le périmètre testé et ce qui ne l’a pas été. « Aucun appel interdit dans ces essais » ne signifie pas « agent invulnérable ». Mentionnez le nombre de cas et de répétitions, les catégories couvertes, les échecs et les contrôles encore manquants. Si un connecteur, une permission ou un modèle change, rejouez les cas concernés avant d’étendre l’usage.
Les recommandations OWASP sur les injections de prompt décrivent des mesures de réduction du risque, pas une protection absolue apportée par un prompt. Pour organiser les responsabilités et la décision de déploiement, reliez cette recette à la gouvernance de l’IA et à la checklist d’auditabilité d’un système.
La protection des données n'est qu'un volet : les bonnes pratiques de gouvernance des agents IA couvrent aussi les permissions, la journalisation et l'arrêt.
Conclusion
Sécuriser un agent IA ne consiste pas à trouver le prompt parfait. Il faut réduire ce que l'agent peut voir, limiter ce qu'il peut faire, valider les actions sensibles, filtrer les sorties et rendre chaque étape observable. Les organisations qui appliquent ces principes peuvent industrialiser les agents sans transformer chaque connecteur en risque systémique.
Questions fréquentes
Pourquoi une consigne de confidentialité ne suffit-elle pas à sécuriser un agent ? La sécurité porte aussi sur les données accessibles et les actions possibles dans les outils. Combinez des permissions appliquées côté serveur, de l’isolation, du filtrage, des traces et une validation humaine pour les actions sensibles.
Comment réduire les droits des outils d’un agent ? Exposez une interface limitée au besoin, en lecture seule lorsque c’est possible, avec des paramètres validés et des refus explicites. Les contrôles doivent être appliqués par les outils et le serveur, au-delà des consignes données au modèle.
Comment tester une barrière sans provoquer d’effet métier ? Utilisez un environnement isolé et des outils simulés, avec des documents fictifs contenant des consignes parasites. Distinguez les actions proposées par le modèle, celles bloquées par le serveur et celles qui auraient été exécutées, puis vérifiez aussi les demandes légitimes.
Quelles traces conserver sans créer une nouvelle fuite ? Conservez les identifiants de cas, les versions, les documents accessibles, les décisions d’autorisation et les résultats observés. Masquez les secrets et limitez la conservation ainsi que l’accès aux traces selon leur finalité et la sensibilité des données.
Sources
Sources principales
- OWASP Top 10 for LLM Applications
- OWASP GenAI : menaces et mitigations des applications agentiques
- NIST AI 600-1: Generative AI Profile
- Microsoft Azure AI Foundry : filtrage de contenu
Pour situer ce sujet dans une démarche complète, Noolya détaille l'audit de conformité IA et l'AI Act.