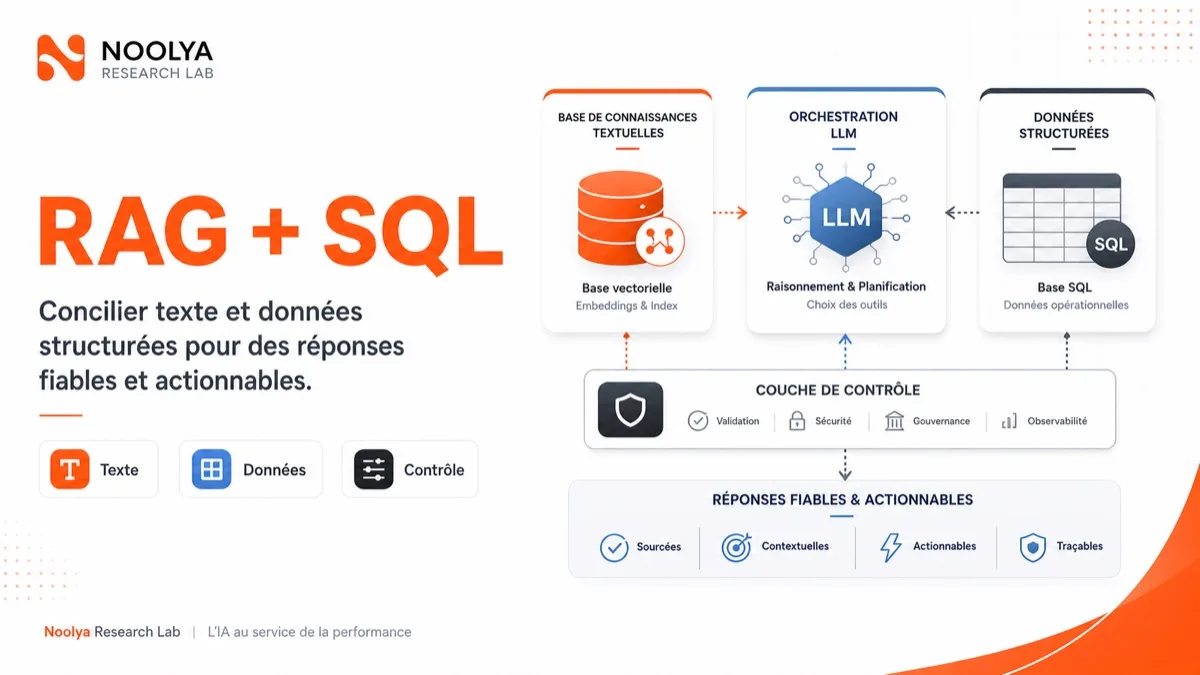
Les premiers projets RAG en entreprise ont souvent été construits autour d'une idée simple: indexer des documents, retrouver les passages pertinents, puis demander au modèle de répondre avec contexte. Cette approche fonctionne bien pour des politiques internes, des bases de connaissance ou des contrats. Elle devient moins robuste quand la question mélange du texte et des données structurées: chiffre d'affaires, stocks, tickets, transactions, niveaux de service, droits d'accès ou historiques client.
Un modèle hybride RAG + SQL répond à ce problème. (Les autres pannes courantes d'un RAG — découpage, droits d'accès, documents périmés — sont traitées dans les problèmes d'un RAG en entreprise.) Il ne cherche pas à forcer toutes les données dans une base vectorielle. Il sépare les sources selon leur nature: les documents restent dans un index de recherche, les données relationnelles restent dans leurs bases contrôlées, et une couche d'orchestration décide quel outil interroger. Le gain n'est pas seulement technique. Il touche la fiabilité, l'auditabilité et la sécurité des réponses.
1. Pourquoi le RAG seul atteint vite ses limites
La recherche vectorielle est efficace pour retrouver des passages sémantiquement proches. Elle est beaucoup moins adaptée aux questions qui exigent un calcul exact: totaliser des ventes, filtrer par date, croiser une région et un statut, compter des incidents, appliquer une règle de droits ou respecter une jointure métier. Transformer une table SQL en fragments textuels peut dépanner, mais cela dégrade souvent la précision.
Le RAG seul pose aussi un problème de fraîcheur. Une base documentaire est souvent réindexée par lots; une base transactionnelle change en continu. Si l'assistant répond sur des indicateurs opérationnels, il doit interroger le système de référence ou une réplique gouvernée, pas une approximation textuelle.
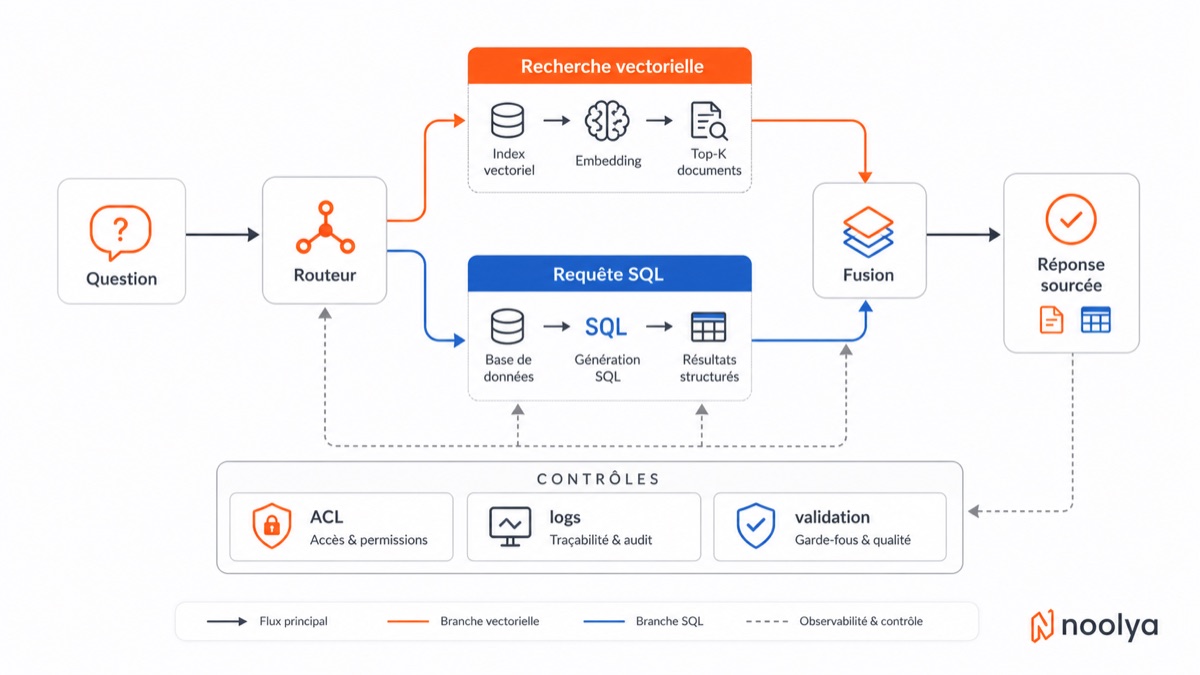
Figure 1 - Une architecture RAG + SQL utile sépare le routage, l'accès documentaire, les requêtes structurées, la fusion et les contrôles de permissions.
2. Le rôle critique du routeur
Le routeur est le composant qui décide si une question relève du texte, du SQL ou des deux. Une demande comme "quelles clauses limitent la résiliation ?" peut passer par le RAG. Une demande comme "combien de contrats expirent dans 90 jours ?" relève du SQL. Une demande comme "quels contrats stratégiques expirent bientôt et quelles clauses posent problème ?" nécessite les deux.
Ce routeur ne doit pas être une simple instruction de prompt. Pour les cas sensibles, il doit s'appuyer sur des schémas autorisés, des fonctions contrôlées, des exemples de requêtes, des règles de permissions et un journal d'exécution. L'objectif est d'éviter que le modèle improvise des jointures, expose des colonnes sensibles ou produise une requête impossible à auditer.
3. Sécuriser les accès avant de générer la réponse
Dans un assistant hybride, les droits d'accès sont plus complexes que dans un chatbot documentaire. L'utilisateur peut avoir le droit de lire une procédure, mais pas les données client détaillées. Il peut accéder à des agrégats, mais pas aux lignes individuelles. Il peut consulter une région, mais pas une autre.
La bonne architecture applique les contrôles avant la récupération. Les ACL documentaires filtrent les passages accessibles. Les requêtes SQL sont générées ou sélectionnées dans un périmètre autorisé. Les logs conservent la question, les sources consultées, les requêtes exécutées et la réponse produite. Sans cette chaîne, la traçabilité devient fragile.
4. Fusionner sans masquer l'incertitude
La fusion des résultats est le moment où beaucoup d'assistants deviennent trop confiants. Un document peut expliquer une règle générale tandis que SQL donne une valeur chiffrée. Si les deux se contredisent, le système doit le signaler. Si la requête SQL porte sur un périmètre incomplet, la réponse doit l'indiquer. Si un document n'est pas récent, sa date doit apparaître.
Un bon assistant hybride cite donc ses sources textuelles, décrit les filtres SQL utilisés et distingue les faits calculés des interprétations générées. Cette discipline donne à l'utilisateur une réponse actionnable sans lui faire croire que le modèle possède une vérité globale.
Pour un livrable de conformité, la préparation d’un reporting réglementaire automatisé permet de prolonger cette distinction entre sources, calculs et interprétations jusqu’à la validation du rapport.
5. Où commencer
Le meilleur point de départ n'est pas un assistant universel. C'est un domaine où les documents et les données tabulaires se complètent: support client, finance, achats, conformité, contrats, supply chain ou reporting ESG. Il faut choisir quelques questions représentatives, cartographier les sources, définir les droits et mesurer la précision sur un jeu de tests.
La métrique clé n'est pas seulement la satisfaction utilisateur. Il faut suivre le taux de routage correct, les requêtes SQL valides, les réponses sourcées, les refus appropriés et les erreurs de périmètre. Le modèle hybride devient alors un système observable, pas une boîte noire conversationnelle.
Conclusion
RAG + SQL n'est pas une sophistication d'architecte. C'est souvent la condition pour rendre un assistant IA utile dans les métiers où les décisions reposent à la fois sur des textes et sur des chiffres. La valeur vient de la séparation des responsabilités: au modèle la compréhension et la synthèse; aux systèmes de données la vérité structurée; à l'orchestration la sécurité, le routage et la traçabilité.
Questions fréquentes
Quand combiner recherche documentaire et requêtes structurées ? Cette combinaison est utile lorsqu’une question mobilise à la fois des passages de documents et des données tabulaires. Conservez chaque source dans son système adapté et utilisez une orchestration qui sélectionne les outils nécessaires à la réponse.
Quel est le rôle du routeur dans un assistant hybride ? Le routeur décide si la question demande une recherche de texte, une requête structurée ou les deux. Encadrez ce choix par des schémas autorisés, des fonctions contrôlées, des règles de permissions et un journal d’exécution.
À quel moment faut-il appliquer les droits d’accès ? Appliquez les contrôles avant la récupération des données. Filtrez les passages documentaires et limitez les requêtes au périmètre autorisé pour l’utilisateur, puis conservez les traces des sources et opérations utilisées.
Comment présenter une réponse lorsque les sources se contredisent ? Signalez les contradictions, les données incomplètes et les limites de fraîcheur au lieu de les masquer. Citez les sources textuelles, décrivez les filtres des requêtes et distinguez les faits calculés des interprétations générées.
Sources
Sources principales
- OpenAI: File Search et vector stores
- Microsoft Azure Architecture Center: retrieval dans les architectures RAG
- Microsoft Azure AI Foundry: concepts RAG
- Google Cloud : application générative RAG avec Vertex AI
Pour situer ce sujet dans une démarche complète, Noolya détaille l'audit de maturité IA.