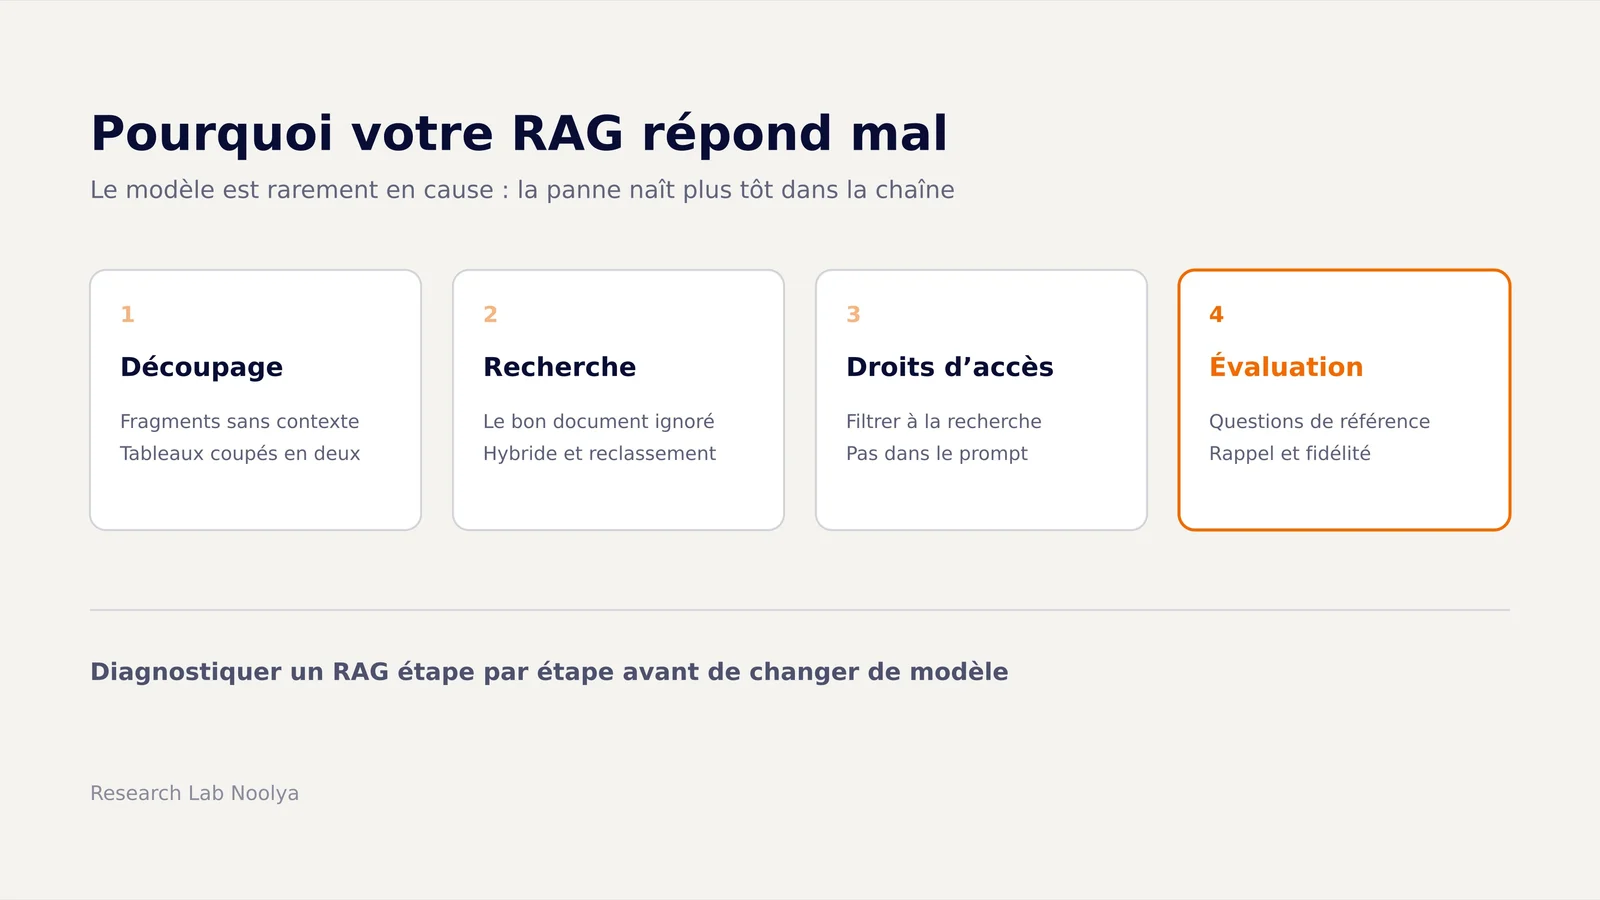
Les problèmes d'un RAG en entreprise viennent rarement du modèle de langage : ils naissent presque toujours plus tôt dans la chaîne, au découpage des documents, à la recherche des passages ou au contrôle des droits d'accès. Un RAG qui répond mal est d'abord un moteur de recherche qui a mal cherché, puis un modèle qui a fait confiance à ce qu'on lui a donné. La correction passe donc par un diagnostic étape par étape, mesuré sur un jeu de questions de référence, plutôt que par un changement de modèle.
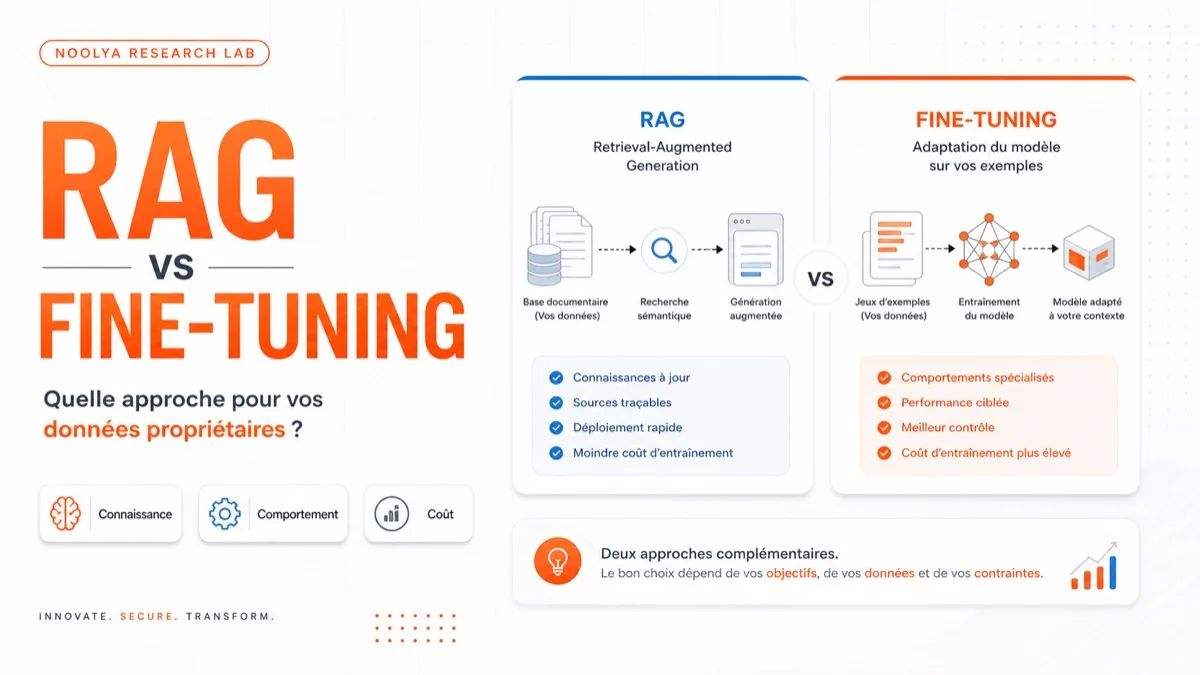
Le principe, proposé en 2020 par Patrick Lewis et ses coauteurs, associe un modèle génératif à un index documentaire interrogé à chaque question. Si vous hésitez encore sur l'architecture, voyez notre comparatif RAG ou fine-tuning pour vos données propriétaires. Ici, on part d'un RAG en place qui déçoit.
Où se situent les problèmes d'un RAG ?
Une chaîne RAG compte six points de défaillance :
- l'ingestion et le découpage : comment les documents sont lus, nettoyés et coupés en fragments ;
- la recherche : quels fragments remontent pour une question donnée ;
- la génération : ce que le modèle fait des fragments reçus ;
- les droits d'accès : qui a le droit de voir quels fragments ;
- la fraîcheur : si l'index reflète l'état actuel des documents ;
- l'évaluation : si l'on sait mesurer tout ce qui précède.
Pourquoi le RAG ignore-t-il le bon document ?
Symptôme. L'utilisateur sait que la réponse figure dans la note de service de mars. Le RAG répond à côté, ou affirme ne rien trouver.
Cause. D'abord, le fragment pertinent a perdu son contexte au découpage : « le plafond passe à 1 500 euros » ne dit ni de quel plafond ni de quelle entité il s'agit, phénomène décrit par Anthropic dans sa publication sur la récupération contextuelle. Ensuite, la recherche purement vectorielle rate les termes exacts (référence produit, acronyme maison), quand la recherche par mots-clés rate les reformulations.
Correction. Combinez recherche par mots-clés et recherche vectorielle (recherche hybride), puis ajoutez un reclassement des résultats. Enrichissez chaque fragment d'un court contexte : titre du document, section, date. Anthropic a mesuré sur ses jeux de test une baisse de 49 % des échecs de récupération en combinant fragments contextualisés et BM25, et de 67 % en ajoutant un reclassement. Ces chiffres valent pour leurs corpus : seul votre jeu de test dira ce qu'il en est chez vous.
Pourquoi le découpage casse-t-il les tableaux ?
Symptôme. Le RAG cite une valeur juste dans la mauvaise colonne, ou mélange deux lignes d'un barème.
Cause. Un découpeur à taille fixe coupe là où le compteur de caractères l'arrête. La ligne d'en-tête d'un tableau se retrouve dans un fragment, les valeurs dans le suivant. Le modèle reçoit des nombres sans intitulés et devine.
Correction. Découpez selon la structure du document (titres, sections, tableaux entiers) plutôt qu'au nombre de caractères. Microsoft propose, comme point de départ pour un découpage à taille fixe, des fragments de 512 tokens avec 25 % de chevauchement, et suggère d'ajouter le titre du document aux fragments issus du milieu du texte. Pour les données vraiment tabulaires, mieux vaut souvent les interroger en SQL : voyez notre article sur les architectures hybrides RAG et SQL pour les données structurées.
Que faire des documents contradictoires ou périmés ?
Symptôme. Le RAG cite l'ancienne procédure, ou présente deux versions d'une même règle comme également valables.
Cause. L'index contient les brouillons, les doublons et les versions abrogées, et rien ne dit au moteur qu'un document en remplace un autre. L'OWASP range d'ailleurs les conflits de connaissances entre sources parmi les faiblesses des systèmes à base de vecteurs (risque LLM08:2025).
Correction. Le problème est éditorial avant d'être technique : un périmètre documentaire validé, un propriétaire par corpus. Ajoutez des métadonnées de version, de date et de statut, et filtrez dessus à la recherche. Côté fraîcheur, l'indexation incrémentale doit aussi supprimer les documents retirés.
Pourquoi le RAG hallucine-t-il malgré le bon contexte ?
Symptôme. Les bons fragments sont remontés, mais la réponse ajoute un détail absent des sources, ou en contredit une.
Cause. Le modèle complète avec ses connaissances générales quand les fragments sont incomplets. Il exploite aussi mal l'information enfouie dans un long contexte : l'étude « Lost in the Middle » (Liu et al., 2023) montre que les performances chutent quand l'information utile se trouve au milieu de l'entrée. Envoyer cinquante fragments « pour être sûr » peut dégrader la réponse.
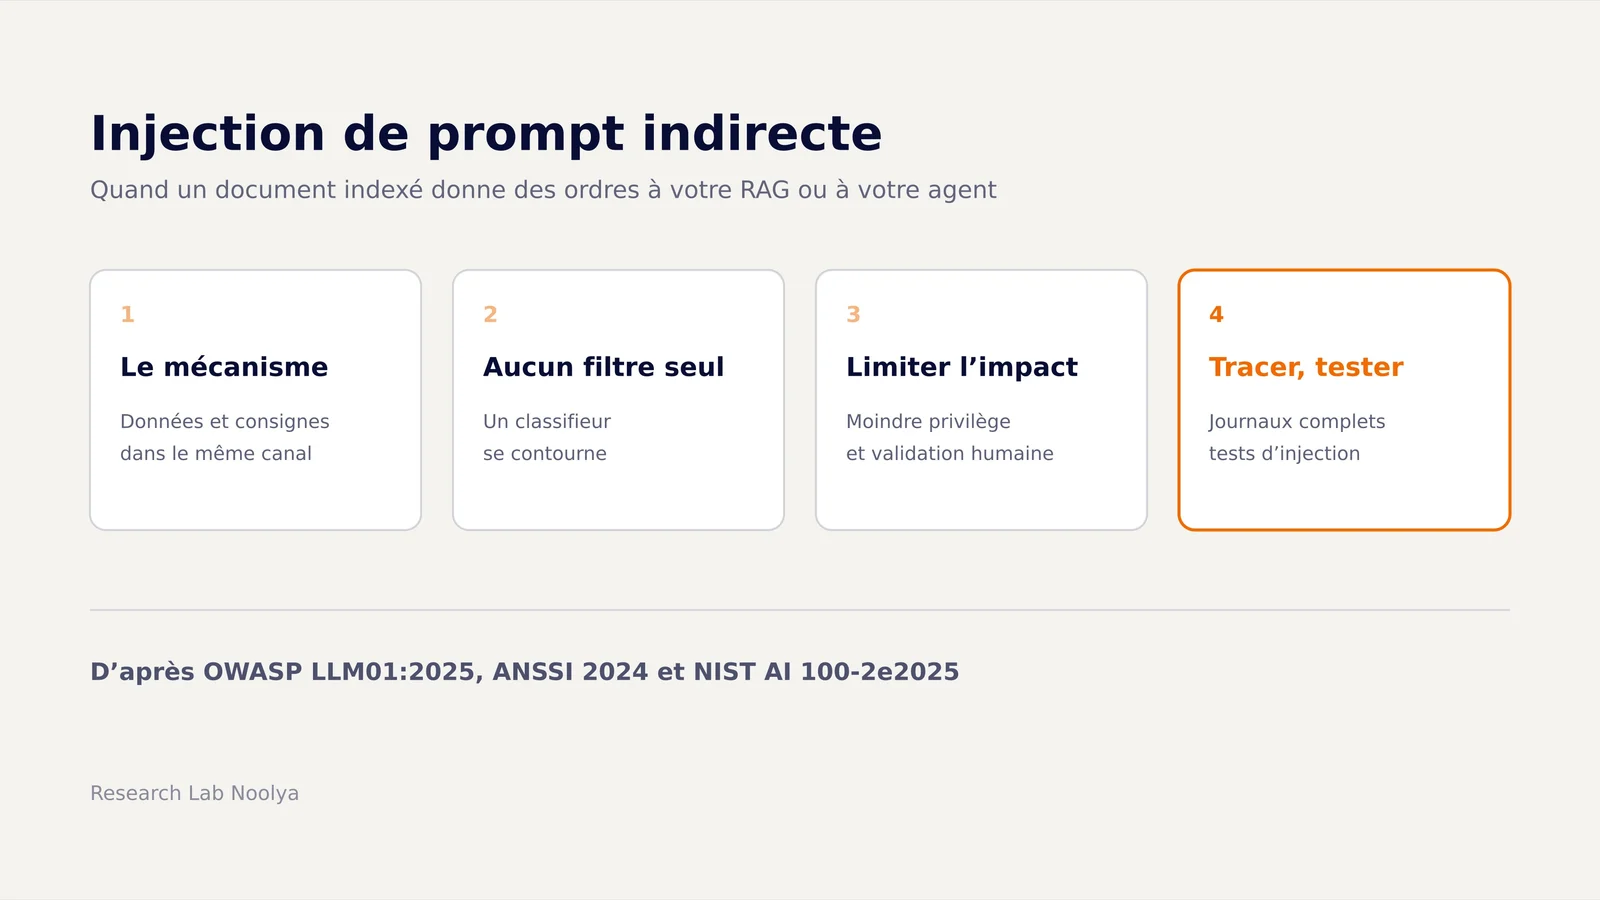
Correction. Limitez et classez les fragments transmis. Demandez au modèle de citer le passage qui fonde chaque affirmation et de répondre « je ne sais pas » faute de source. Mesurez la fidélité de façon systématique (voir plus bas). Enfin, traitez le contenu des documents comme une donnée et jamais comme une instruction : un document piégé peut détourner le modèle, sujet que nous détaillons dans notre article sur la robustesse d'un RAG face aux injections de prompts indirectes.
Comment un RAG peut-il divulguer des documents interdits ?
Symptôme. Un collaborateur obtient, par une question anodine, le contenu d'une note RH ou d'un dossier financier qu'il n'aurait jamais pu ouvrir directement.
Cause. Les documents ont été copiés dans un index vectoriel sans leurs permissions, qui devient un accès parallèle contournant les droits de la source. L'OWASP cite cet accès non autorisé et les fuites entre contextes comme premiers risques de la catégorie LLM08:2025.
Correction. Filtrez par droits au moment de la recherche, avant que les fragments n'atteignent le modèle : c'est le « security trimming » documenté par Microsoft pour Azure AI Search, qui peut hériter des permissions Microsoft Entra ID ou SharePoint. Demander au modèle de « ne pas divulguer » ne remplace jamais un filtre. Et si les droits de la source sont eux-mêmes trop ouverts, le RAG les exposera fidèlement : c'est le même chantier que celui décrit dans notre article sur les droits SharePoint à vérifier avant un déploiement Copilot. Journalisez les recherches pour pouvoir reconstituer qui a obtenu quoi.
Pourquoi un RAG coûte-t-il cher et répond-il lentement ?
Symptôme. Chaque réponse prend de longues secondes et la facture d'inférence grimpe avec l'usage.
Cause. Trop de fragments envoyés, des requêtes reformulées plusieurs fois, un reclassement appliqué à des centaines de candidats, et un modèle surdimensionné pour la tâche.
Correction. Mesurez le temps passé à chaque étape et réduisez le nombre de fragments transmis tant que la qualité tient. Anthropic rappelle aussi qu'en dessous d'environ 200 000 tokens (de l'ordre de 500 pages), on peut placer toute la base dans le prompt et se passer de RAG, la mise en cache du prompt rendant l'opération plus rapide et moins chère. Pour un petit corpus stable, c'est souvent la solution la plus simple.
Tableau récapitulatif des problèmes d'un RAG
| Étape | Symptôme | Cause principale | Correction |
|---|---|---|---|
| Recherche | Le bon document est ignoré | Fragment sans contexte, recherche vectorielle seule | Recherche hybride, reclassement, fragments contextualisés |
| Découpage | Valeurs de tableau mélangées | Coupe à taille fixe qui sépare en-têtes et données | Découpage structurel, tableaux en SQL |
| Fraîcheur | Ancienne version citée | Doublons et versions abrogées dans l'index | Périmètre validé, métadonnées de version, suppression synchronisée |
| Génération | Détail inventé malgré les sources | Contexte incomplet ou trop long | Moins de fragments, citations obligatoires, mesure de fidélité |
| Droits d'accès | Document interdit divulgué | Index copié sans permissions | Filtrage par droits à la recherche, journalisation |
| Coût et latence | Réponses lentes et chères | Trop de fragments, modèle surdimensionné | Mesure par étape, réduction du contexte, prompt complet si petit corpus |
| Évaluation | Impossible de dire si ça s'améliore | Aucun jeu de test | Questions de référence, métriques de récupération et de fidélité |
Comment évaluer un RAG ?
Sans jeu de test, chaque modification se juge à l'impression du jour. La méthode tient en trois temps :
- Constituer un jeu de questions de référence. Une centaine de questions réelles, posées par les métiers, avec pour chacune la réponse attendue et le ou les documents qui la fondent. Incluez des questions sans réponse dans le corpus et des questions qu'un profil donné n'a pas le droit de voir.
- Mesurer la récupération séparément de la génération. Le cadre open source RAGAS distingue la précision du contexte (les fragments pertinents sont-ils classés en tête ?) et le rappel du contexte (les informations nécessaires ont-elles toutes été récupérées ?), ce dernier exigeant une réponse de référence.
- Mesurer la fidélité de la réponse. Dans RAGAS, la fidélité (faithfulness) découpe la réponse en affirmations et calcule la part de celles que le contexte récupéré permet de soutenir, sur une échelle de 0 à 1. La pertinence de la réponse (response relevancy) et la sensibilité au bruit complètent le tableau.
Rejouez ce jeu à chaque changement de découpage, de modèle ou de paramètre : c'est ce qui sépare un prototype d'un système maintenable, et la démarche de nos missions d'intégration de l'IA en entreprise.
Questions fréquentes
Quel est le problème le plus fréquent dans un RAG d'entreprise ? Le plus souvent, c'est la recherche qui échoue, pas le modèle. Les fragments pertinents ne remontent pas, faute de contexte après découpage ou parce que la recherche vectorielle seule rate les termes exacts. Une recherche hybride avec reclassement est la première correction à tester.
Changer de modèle de langage améliore-t-il un RAG qui répond mal ? Rarement, si les bons passages ne lui parviennent pas. Un modèle plus puissant reformule mieux une réponse fondée sur de mauvais fragments, sans la rendre juste. Il faut d'abord mesurer la récupération, puis la génération.
Comment empêcher un RAG de montrer des documents confidentiels ? En filtrant les fragments selon les droits de l'utilisateur au moment de la recherche, avant qu'ils n'atteignent le modèle. Une consigne dans le prompt ne constitue pas un contrôle d'accès. Il faut aussi vérifier que les droits de la source documentaire sont eux-mêmes correctement réglés.
Quels outils permettent d'évaluer un RAG ? Le cadre open source RAGAS propose des métriques de précision et de rappel du contexte, de fidélité et de pertinence des réponses. Sa valeur dépend du jeu de questions de référence construit avec les métiers.
Sources
- Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks — article fondateur du RAG, Lewis et al., NeurIPS 2020
- Introducing Contextual Retrieval — Anthropic, septembre 2024, mesures de réduction des échecs de récupération
- Lost in the Middle: How Language Models Use Long Contexts — Liu et al., 2023, effet de la position de l'information dans le contexte
- RAG and Generative AI - Azure AI Search — Microsoft Learn, défis du RAG, recherche hybride et security trimming
- Chunk Documents - Azure AI Search — Microsoft Learn, stratégies de découpage et chevauchement
- List of available metrics - Ragas — documentation RAGAS, métriques de récupération et de génération
- Faithfulness - Ragas — documentation RAGAS, calcul de la fidélité
- LLM08:2025 Vector and Embedding Weaknesses — OWASP Gen AI Security Project, fuites et conflits de connaissances