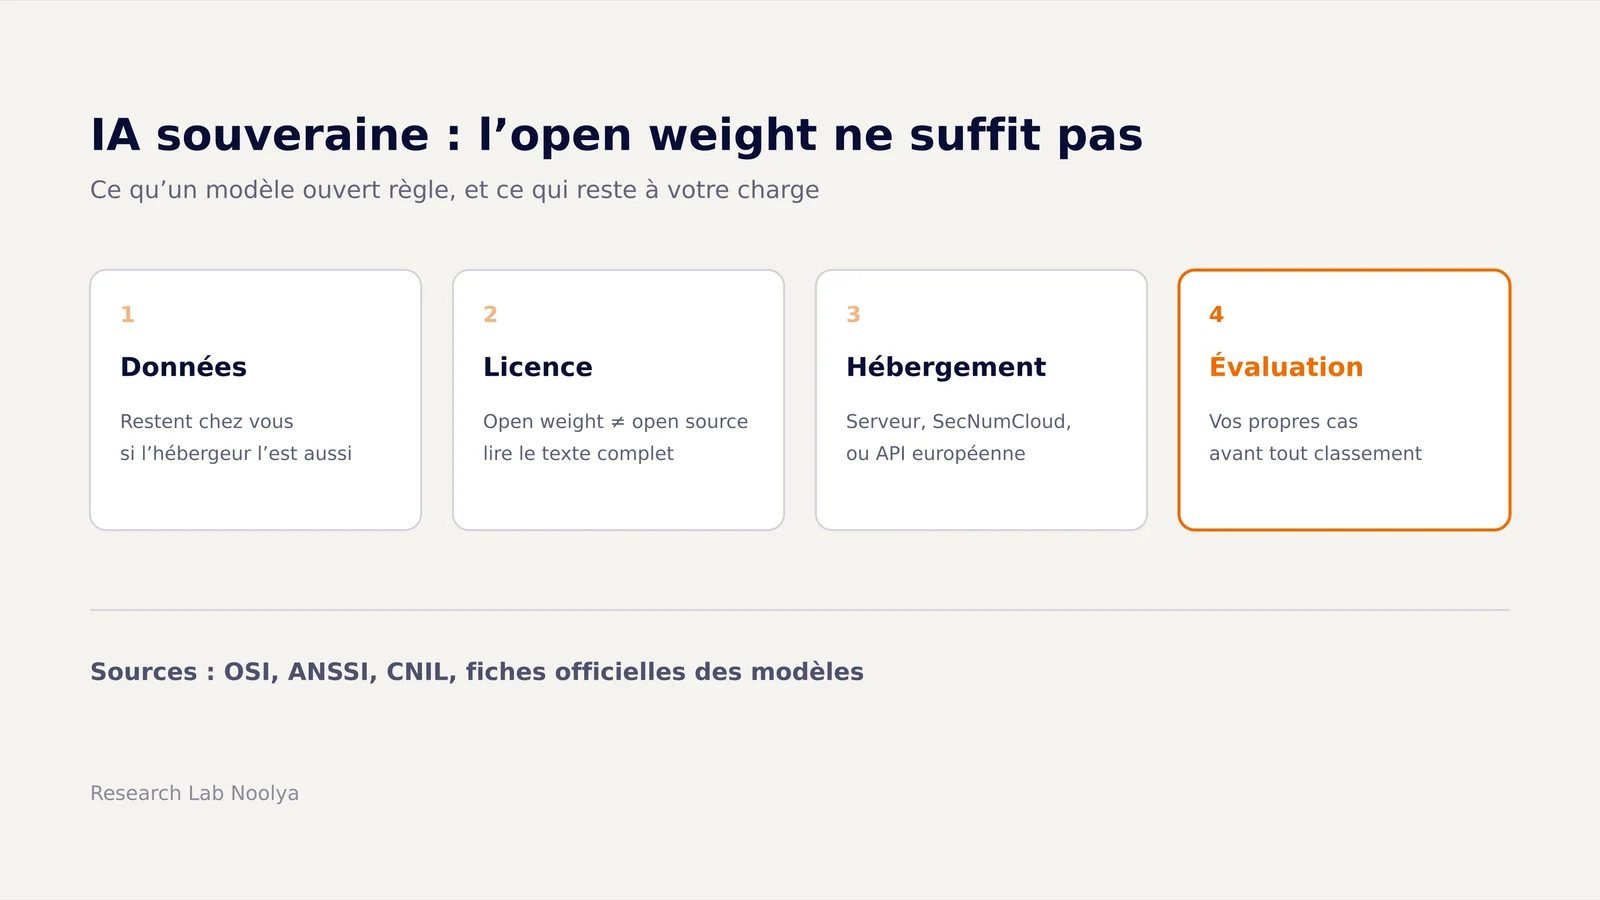
Déployer un modèle open weight en entreprise résout trois problèmes de souveraineté : les données ne quittent pas l'infrastructure que vous choisissez, vous décidez quand changer de version, et le coût dépend de votre matériel plutôt que d'une grille tarifaire externe. Il ne résout pas le reste : la souveraineté de l'infrastructure qui fait tourner le modèle, la licence réelle des poids, la maintenance, la sécurité et l'évaluation. Une IA souveraine se construit donc en combinant un modèle ouvert, un hébergement maîtrisé et une équipe capable de l'exploiter.
Que résout vraiment un modèle ouvert ?
Un modèle open weight est un modèle dont les poids sont téléchargeables : vous le faites tourner où vous voulez, sans appeler l'API de l'éditeur. Trois bénéfices en découlent.
Les données restent là où vous les mettez. Les prompts, les documents injectés et les réponses ne transitent pas par l'éditeur du modèle. Mais l'argument ne vaut que pour le modèle : si l'hébergeur, la journalisation ou la recherche documentaire sont externes, les données y passent aussi.
Vous maîtrisez les versions. Un fournisseur d'API peut retirer un modèle, modifier son comportement ou changer ses conditions. Avec des poids stockés chez vous, la version validée reste disponible tant que vous la gardez.
Le coût devient prévisible. Vous payez des GPU, de l'énergie et du temps d'exploitation, pas des jetons. Ce n'est pas forcément moins cher : un serveur sous-utilisé coûte plus qu'une API facturée à l'usage. Le calcul se fait au volume réel, avec les leviers décrits dans notre guide pour optimiser les coûts d'inférence d'un LLM (quantification, distillation, cache).
Un modèle open weight est-il un modèle open source ?
Non. L'Open Source Initiative a publié l'Open Source AI Definition 1.0. Elle exige quatre libertés (utiliser, étudier, modifier, partager) et l'accès à la « forme préférée » pour modifier le système : les paramètres, le code complet d'entraînement et d'exécution, et une information suffisamment détaillée sur les données d'entraînement pour qu'une personne compétente puisse construire un système substantiellement équivalent. La plupart des modèles dits ouverts publient les poids et le code d'inférence, rarement le reste.
La CNIL fait le même constat dans sa note d'analyse sur les pratiques open source en IA : de nombreux modèles sont qualifiés d'« ouverts » alors que leurs conditions d'accès sont fondamentalement différentes. Chez Mistral AI, la page des modèles liste Mistral Small 4 et la famille Ministral 3 sous Apache 2.0, une licence approuvée par l'OSI. Elle liste aussi Mistral Medium 3.5 sous une « Modified MIT ». Le texte de cette licence interdit d'exercer les droits accordés si le chiffre d'affaires mensuel consolidé de l'entreprise dépasse 20 millions de dollars, sauf licence commerciale négociée avec Mistral. Le même mot « MIT » recouvre donc deux réalités pour une grande entreprise.
À l'inverse, DeepSeek indique que les poids de DeepSeek-V4-Flash sont publiés sous licence MIT, ce que nous détaillons dans notre analyse de DeepSeek-V4-Flash-0731 et de sa licence MIT. Une licence permissive sur les poids ne fait pas pour autant un « Open Source AI » au sens de l'OSI si les données et le code d'entraînement manquent. La même lecture s'impose pour les modèles ouverts venus de Chine, comme GLM-5.2 et ses ambitions sur les tâches longues : lire la licence avant de lire les benchmarks.
Qu'est-ce qu'un modèle ouvert ne résout pas ?
La souveraineté de l'infrastructure. Un modèle européen chez un hébergeur soumis au droit américain reste exposé à ce droit. Le CLOUD Act de 2018 a inséré une disposition (18 U.S.C. § 2713) qui oblige un fournisseur de services de communication électronique ou de calcul à distance à préserver ou divulguer les données en sa possession, sous sa garde ou sous son contrôle, qu'elles soient situées aux États-Unis ou à l'étranger. Cet article ne constitue pas un conseil juridique : l'exposition réelle dépend des contrats, de la structure du prestataire et de la nature des données, et mérite l'avis d'un juriste.
Sur le volet international, la lecture de l’AI Diffusion Rule et de sa rescission aide à poser les questions de diffusion des modèles et de continuité d’accès.
La maintenance. Un modèle auto-hébergé est un logiciel en production. Serveur d'inférence, correctifs, supervision, gestion de capacité, astreinte : beaucoup de projets de « LLM local » échouent sur l'absence d'exploitant, pas sur la qualité du modèle.
La sécurité. La CNIL rappelle deux risques propres aux modèles diffusés ouvertement : des poids modifiés peuvent contenir des portes dérobées, et les filtres de sécurité peuvent être contournés ou rendus caducs, y compris involontairement par un fine-tuning. Télécharger les poids depuis le dépôt officiel de l'éditeur, contrôler leur intégrité et tester les garde-fous après chaque adaptation fait partie du déploiement.
L'évaluation. Être ouvert ne dit rien de la qualité sur vos dossiers. Aucun classement public ne remplace un jeu de test construit à partir de vos propres cas.
Serveur propre, cloud SecNumCloud ou API européenne : quelles options ?
Trois architectures reviennent dans les projets de plateforme souveraine open source.
Le modèle ouvert sur vos serveurs (sur site ou en hébergement dédié). Contrôle maximal, mais vous portez tout : achat de GPU, exploitation, sécurité physique et logique.
Le modèle ouvert sur un cloud qualifié SecNumCloud. L'ANSSI précise que SecNumCloud qualifie une offre de cloud spécifique, pas un fournisseur ni une infrastructure, et qu'une offre hébergée sur une offre qualifiée n'est pas automatiquement qualifiée elle-même. Depuis la version 3.2 du référentiel, la qualification impose une protection contre les lois extra-européennes, un siège social dans un État membre de l'UE et la localisation dans l'UE des données, y compris techniques comme les journaux. Vérifiez que le service précis utilisé (IaaS avec GPU, par exemple) figure au catalogue des offres qualifiées.
L'API d'un fournisseur européen. Mise en route rapide, aucun GPU à gérer. En contrepartie, l'éditeur décide du calendrier des versions et de l'évolution de ses produits, comme le montre la migration des usages vers Mistral Vibe. La nationalité du fournisseur ne suffit pas : lisez où les données sont traitées, combien de temps elles sont conservées et quels sous-traitants interviennent. Point utile : Mistral publie une partie de ses modèles à la fois en poids ouverts et via son API, ce qui permet de commencer par l'API puis de rapatrier le même modèle.
| Critère | Serveur propre | Cloud SecNumCloud | API européenne |
|---|---|---|---|
| Où vont les données | Votre infrastructure | Offre qualifiée, données localisées dans l'UE | Infrastructure du fournisseur, selon contrat |
| Exposition aux lois extra-européennes | Dépend de vos propres prestataires | Protection exigée par le référentiel 3.2 | À vérifier : structure, hébergement, sous-traitants |
| Choix et version du modèle | Libre, figé tant que vous le décidez | Libre, figé tant que vous le décidez | Catalogue et calendrier du fournisseur |
| Compétences requises | Élevées (infra, GPU, MLOps, sécurité) | Moyennes (déploiement, MLOps) | Faibles (intégration API) |
| Structure de coût | Investissement matériel, coût fixe | Location de capacité | Paiement à l'usage |
| Délai de mise en route | Semaines à mois (achat, installation) | Variable selon l'offre GPU disponible | Jours |
Le choix se fait souvent par cas d'usage : une API pour le peu sensible, un hébergement maîtrisé pour les données qui ne doivent pas sortir.
Comment choisir un modèle ouvert pour l'entreprise ?
La licence, texte complet. Ne vous fiez pas à l'étiquette. Cherchez les seuils de chiffre d'affaires, les restrictions d'usage, les obligations d'attribution et les conditions de redistribution d'un modèle affiné.
La taille et le matériel. La fiche de Ministral 3 8B indique qu'il tient dans 12 Go de mémoire GPU en FP8. Mistral Small 4 compte 119 milliards de paramètres, dont environ 6 milliards actifs par jeton, et Mistral indique une infrastructure minimale de 4 NVIDIA HGX H100, 2 HGX H200 ou 1 DGX B200. Mistral Medium 3.5 est un modèle dense de 128 milliards de paramètres dont les commandes de service, sur sa fiche, répartissent le modèle sur huit GPU. Pour un mélange d'experts, la mémoire se dimensionne sur les paramètres totaux, pas sur les paramètres actifs.
La langue française. Les fiches de Ministral 3 et de Mistral Medium 3.5 mentionnent explicitement le français. Testez ensuite sur vos documents : un modèle correct en français courant peut être faible sur le vocabulaire juridique ou médico-social.
L'évaluation sur vos propres cas. Constituez quelques dizaines de cas réels avec la réponse attendue et un critère de validation, puis comparez deux ou trois modèles, y compris une API fermée comme référence. Mesurez la justesse, le taux de refus inutiles, la latence et le coût par tâche terminée. Rejouez ce jeu à chaque changement de version.
C'est ce cadrage que nous menons dans nos missions d'intégration de l'IA en entreprise : choisir l'architecture selon la sensibilité des données, puis le modèle selon des tests mesurables.
Questions fréquentes
Un modèle open weight est-il un modèle open source ? Pas nécessairement. L'Open Source AI Definition 1.0 de l'OSI exige les poids, mais aussi le code d'entraînement et une information détaillée sur les données d'entraînement. La plupart des modèles dits ouverts ne publient que les poids et le code d'inférence.
Héberger un modèle ouvert chez un cloud américain en région Europe garantit-il la souveraineté ? Non. Le CLOUD Act (18 U.S.C. § 2713) permet d'exiger d'un fournisseur soumis au droit américain les données sous son contrôle, où qu'elles soient stockées. La localisation des serveurs ne suffit pas ; la structure et la juridiction du prestataire comptent autant.
Quel matériel faut-il pour un LLM local en entreprise ? Tout dépend du modèle. Un petit modèle comme Ministral 3 8B tient dans 12 Go de mémoire GPU en FP8, alors que Mistral Small 4 demande au minimum un serveur GPU de centre de données (par exemple un DGX B200) selon Mistral.
SecNumCloud est-il obligatoire pour déployer une IA souveraine ? Pas pour toutes les entreprises : la qualification sert surtout de repère vérifiable quand les données sont sensibles ou qu'un client public l'exige. Elle porte sur une offre précise, pas sur un fournisseur, et impose depuis la version 3.2 une protection contre les lois extra-européennes. Vérifiez vos obligations sectorielles avec un juriste.
Sources
- The Open Source AI Definition – 1.0 — Open Source Initiative, libertés et éléments exigés (paramètres, code, information sur les données)
- FAQ avant de se lancer dans la qualification SecNumCloud — ANSSI, périmètre de la qualification et protection contre les lois extra-européennes
- Les pratiques open source en intelligence artificielle — CNIL, note d'analyse sur la diversité des modèles « ouverts » et leurs risques de sécurité
- Models overview — Mistral AI, licences des modèles ouverts et des modèles propriétaires
- Mistral Medium 3.5 128B — LICENSE — texte de la Modified MIT et seuil de 20 millions de dollars de chiffre d'affaires mensuel
- Introducing Mistral Small 4 — Mistral AI, licence Apache 2.0, paramètres et infrastructure minimale
- Ministral 3 8B Instruct 2512 — fiche du modèle, licence, mémoire GPU et langues
- 18 U.S. Code § 2713 — Cornell LII, texte de la disposition issue du CLOUD Act