La confidentialité différentielle (differential privacy) est une garantie mathématique : le résultat d'un calcul, y compris l'entraînement d'un modèle d'IA, change à peine selon qu'une personne figure ou non dans les données. On ne peut donc pas déduire du résultat ce qui concerne un individu en particulier. Pour entraîner un modèle sur des données sensibles (santé, RH, finance), c'est une protection dont l'efficacité se mesure au lieu de se supposer.
Noolya met en œuvre l'entraînement avec confidentialité différentielle dans ses projets sur données sensibles, en complément de la pseudonymisation et de l'anonymisation des données de santé.
Pourquoi un modèle peut divulguer ses données d'entraînement
Un modèle apprend des régularités, mais il retient parfois des exemples précis. En 2021, Nicholas Carlini et ses coauteurs ont montré qu'il était possible d'extraire d'un grand modèle de langage des passages entiers de ses données d'entraînement, y compris des noms, des numéros de téléphone et des adresses e-mail. Le risque est plus fort pour les exemples rares, qui sont justement ceux qui identifient une personne : une pathologie peu fréquente, un parcours atypique.
Retirer les noms avant l'entraînement ne suffit pas toujours. Le modèle peut retenir la combinaison d'éléments qui, elle, désigne quelqu'un. Le Comité européen de la protection des données l'a pris en compte dans son avis 28/2024 : pour qu'un modèle entraîné sur des données personnelles puisse être considéré comme anonyme, la probabilité d'en extraire des données personnelles, directement ou par des requêtes, doit être négligeable, et cela s'évalue au cas par cas.
Comment fonctionne la confidentialité différentielle
L'idée, formalisée en 2006 par Cynthia Dwork et ses coauteurs, est de rendre le résultat indifférent à la présence d'un individu. Un paramètre, noté ε (epsilon), mesure cette indifférence : plus il est petit, plus la protection est forte, et plus le résultat est bruité.
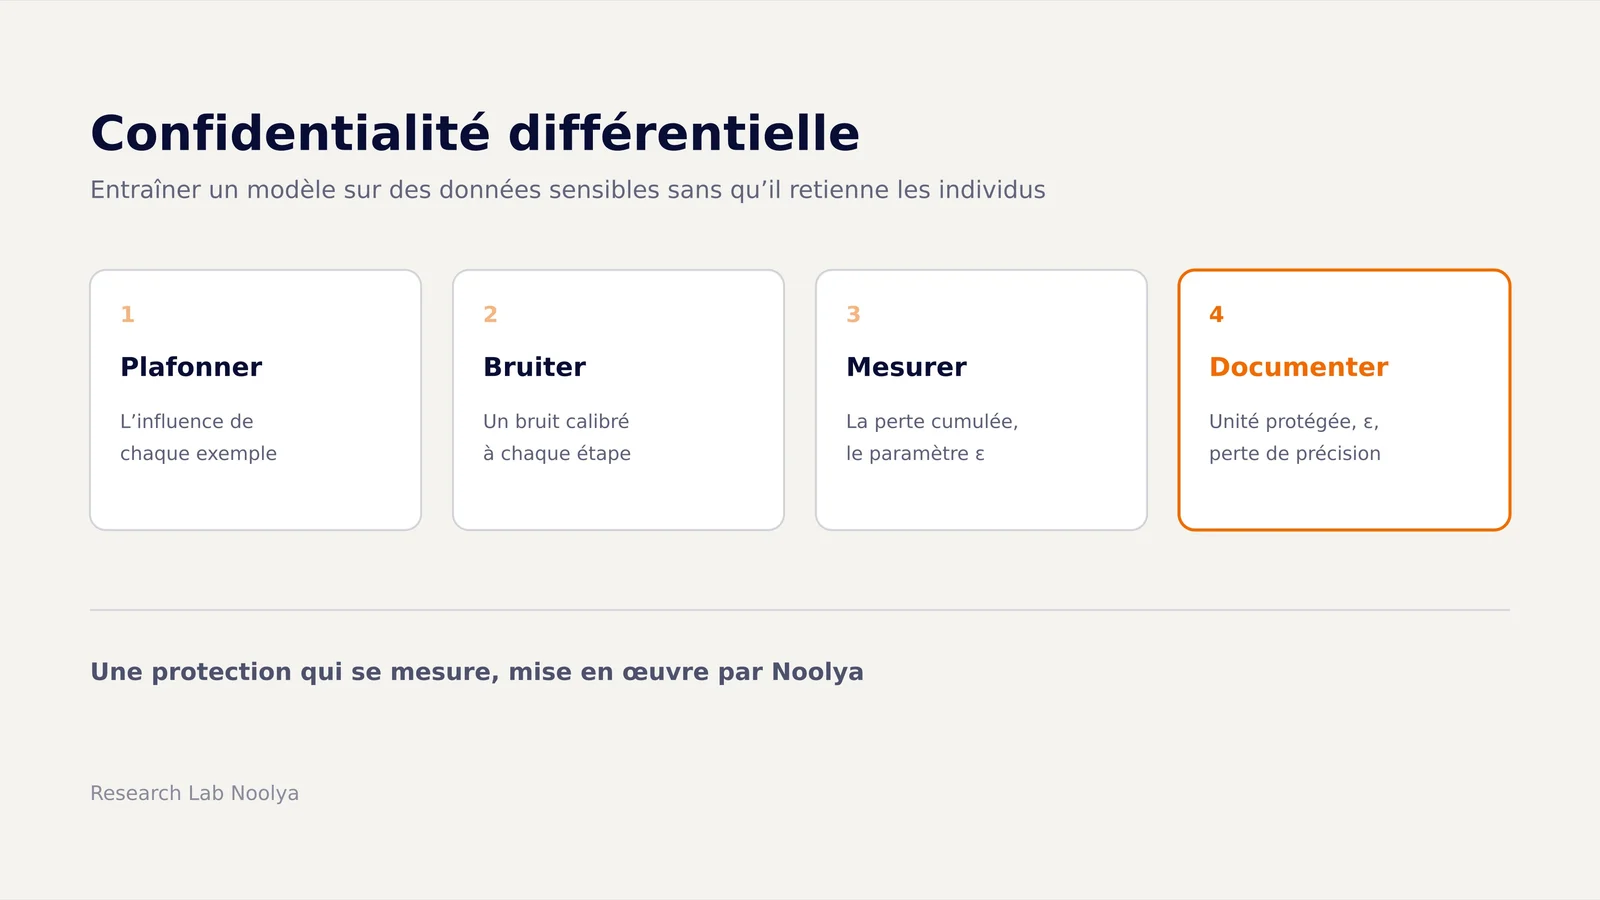
Pour l'entraînement des réseaux de neurones, la méthode de référence est le DP-SGD, proposé par Martín Abadi et ses coauteurs en 2016. À chaque étape d'apprentissage :
- l'influence de chaque exemple sur la mise à jour du modèle est plafonnée ;
- un bruit aléatoire calibré est ajouté à la mise à jour ;
- la perte de confidentialité cumulée est comptabilisée au fil de l'entraînement, pour connaître la garantie finale.
Des bibliothèques open source établies, comme Opacus pour PyTorch ou TensorFlow Privacy, implémentent ces mécanismes.
| Technique | Ce qu'elle protège | Limite |
|---|---|---|
| Pseudonymisation | Les identifiants directs dans les données | Données toujours personnelles ; le modèle peut mémoriser des combinaisons |
| Anonymisation des données | Le jeu d'entraînement lui-même | Doit être démontrée ; difficile sur du texte libre riche |
| Confidentialité différentielle | Ce que le modèle entraîné révèle sur chaque personne | Coût en précision ; demande plus de données et un réglage de ε |
| Contrôle des sorties | Ce que le modèle répond | Ne protège pas contre l'extraction par d'autres requêtes |
Ces techniques se combinent. Sur des données de santé, nous pseudonymisons ou anonymisons d'abord les données, puis nous entraînons avec confidentialité différentielle quand le modèle doit être partagé, exposé ou réutilisé.
Ce qu'il faut décider avant d'entraîner
Le NIST a publié en mars 2025 ses lignes directrices pour évaluer les garanties de confidentialité différentielle (SP 800-226). Elles insistent sur ce que la garantie promet, et sur ce qu'elle ne promet pas. En pratique, quatre décisions comptent :
- L'unité protégée. Protège-t-on un enregistrement, ou une personne qui peut avoir des dizaines d'enregistrements ? Un patient avec dix séjours n'est pas protégé si l'on raisonne séjour par séjour.
- La valeur de ε. Elle se justifie au regard du risque et de l'usage du modèle, et se documente. Une valeur annoncée sans unité ni méthode de calcul ne garantit rien.
- Le coût en précision. Le bruit dégrade la performance, surtout sur les cas rares. On mesure la perte sur un jeu de test et on décide si elle est acceptable.
- La chaîne complète. La garantie porte sur l'entraînement. Les journaux, les jeux de test, les exports intermédiaires et les sorties du modèle doivent être protégés par ailleurs.
Ce que Noolya fait concrètement
Sur les projets qui touchent des données sensibles, Noolya :
- cartographie les données et choisit, pour chaque usage, entre pseudonymisation, anonymisation et confidentialité différentielle ;
- entraîne les modèles avec confidentialité différentielle lorsque le modèle doit sortir du périmètre des données ou être utilisé largement ;
- documente l'unité protégée, la valeur de ε, la méthode de comptabilisation et la perte de performance mesurée, pour que la garantie soit vérifiable par un DPO ou un auditeur ;
- exécute tout dans l'environnement du client, sur une infrastructure adaptée à la nature des données, comme un hébergement certifié HDS pour la santé.
Cette documentation s'inscrit dans la logique de l'auditabilité d'un système d'IA : une protection qu'on ne peut pas prouver ne protège personne en cas de contrôle. Pour un projet sur vos propres données, un audit IA permet de choisir la bonne combinaison avant d'entraîner quoi que ce soit.
Cet article présente des repères techniques et réglementaires généraux ; il ne constitue pas un conseil juridique.
Questions fréquentes
Qu'est-ce que la confidentialité différentielle ? C'est une garantie mathématique selon laquelle le résultat d'une analyse ou d'un entraînement change très peu, qu'une personne donnée figure ou non dans les données. On ne peut donc pas en déduire d'information propre à cet individu. Sa force se règle par un paramètre, epsilon : plus il est petit, plus la protection est forte.
Un modèle entraîné avec confidentialité différentielle est-il anonyme au sens du RGPD ? Pas automatiquement. Le CEPD demande une évaluation au cas par cas : la probabilité d'extraire des données personnelles du modèle doit être négligeable. La confidentialité différentielle réduit fortement ce risque et permet de le quantifier, mais la conclusion dépend du réglage, de l'unité protégée et de l'usage du modèle.
La confidentialité différentielle dégrade-t-elle les performances du modèle ? Oui, le bruit ajouté a un coût en précision, plus sensible sur les cas rares et quand les données sont peu nombreuses. Ce coût se mesure sur un jeu de test, ce qui permet de choisir un compromis documenté entre protection et performance.
Noolya utilise-t-elle la confidentialité différentielle ? Oui. Noolya entraîne des modèles avec confidentialité différentielle dans ses projets sur données sensibles, en complément de la pseudonymisation et de l'anonymisation, et documente la garantie obtenue pour qu'elle puisse être vérifiée.
Sources
- Guidelines for Evaluating Differential Privacy Guarantees, NIST SP 800-226 — NIST, mars 2025
- Deep Learning with Differential Privacy — Abadi et al., ACM CCS 2016 (DP-SGD)
- Extracting Training Data from Large Language Models — Carlini et al., USENIX Security 2021
- Opinion 28/2024 on certain data protection aspects related to the processing of personal data in the context of AI models — Comité européen de la protection des données
- Opacus — bibliothèque d'entraînement avec confidentialité différentielle pour PyTorch