Claude Sonnet 5.5 mérite une évaluation sur les tâches courantes de l'entreprise, avec un coût calculé sur le résultat accepté. Remplacer partout un modèle plus coûteux serait pourtant une décision prématurée : une extraction, une correction de code et une validation contractuelle n'ont ni la même difficulté ni les mêmes conséquences en cas d'erreur.
L'annonce du 28 septembre 2026 ouvre surtout une question d'organisation. Quelles tâches peuvent rejoindre un palier rapide ? Lesquelles nécessitent encore une revue approfondie ? Ce guide propose une méthode de routage à expérimenter. Les exemples sont fictifs ; Noolya ne présente pas ici un benchmark réalisé chez un client.
Que change réellement Sonnet 5.5 ?
Sonnet 5.5 est présenté par Anthropic comme le complément rapide d'Opus 5.5 pour les travaux bien délimités. L'éditeur annonce une génération plus rapide et jusqu'à 30 % de coût en moins par tâche dans ses tests. Les prix unitaires restent identiques à ceux de Sonnet 5 : 2 dollars par million de jetons entrants et 10 dollars par million de jetons sortants. Le gain annoncé vient donc aussi du nombre de jetons nécessaires, pas d'une remise universelle sur la facture. Annonce Anthropic.
Une réponse moins longue peut coûter moins cher et demeurer inutilisable. Inversement, une réponse plus coûteuse peut éviter une reprise manuelle importante. La comparaison doit porter sur un livrable conforme, accompagné du temps de correction qu'il a demandé. Cette logique prolonge notre analyse du coût par tâche d'Opus 5.5.
Comment classer les tâches avant de choisir le modèle ?
Le routage commence par la difficulté vérifiable et l'impact de l'erreur. Un résumé interne révisable peut passer dans un palier rapide. Une modification de permissions ou une décision engageante doit conserver un contrôle spécifique, même si le modèle paraît capable de la réaliser.
Construisez une fiche par famille de tâches : entrée autorisée, sortie attendue, personne responsable, délai utile et défaut qui bloque la livraison. Une catégorie « documents » est trop large. Il faut distinguer la mise en forme d'une note déjà validée, l'extraction de champs et la rédaction d'une recommandation nouvelle. Le niveau de contrôle suit cette différence.
Définissez ensuite une voie normale et une voie d'escalade. La première traite les cas explicites. La seconde prend les données contradictoires, les demandes hors périmètre et les échecs de validation. L'escalade peut appeler un autre modèle, une règle déterministe ou une personne. Un modèle plus grand n'est pas systématiquement la meilleure sortie.
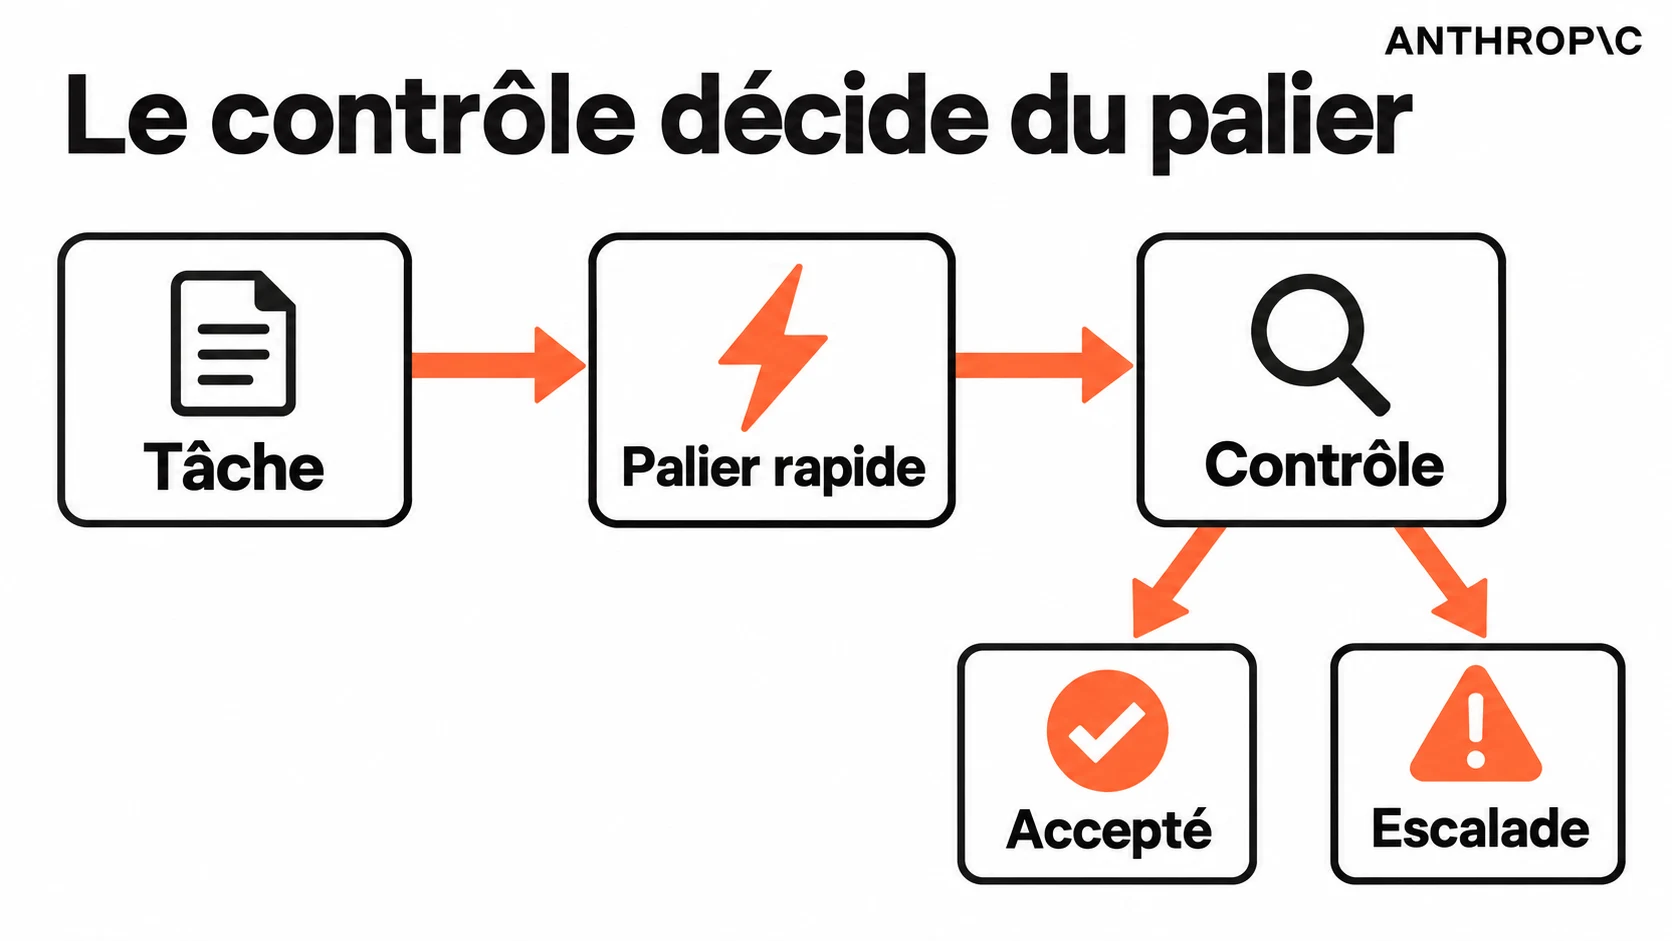
Méthode proposée : affecter un palier à une tâche, puis contrôler la sortie avant de décider de l'escalade.
Quel pilote permet une décision fiable ?
Un pilote fiable compare les mêmes cas, les mêmes règles de validation et les mêmes conditions d'accès. Assemblez des demandes représentatives du travail réel, avec des cas ordinaires et des cas difficiles. Les proportions dépendent de l'usage ; aucun volume magique ne garantit la qualité du test.
Gardez une partie des cas hors du réglage des prompts. Sinon, le test mesure surtout la capacité à s'adapter aux exemples déjà vus. Faites relire les résultats sans afficher le nom du modèle quand le contexte le permet. Une présentation agréable ne doit pas masquer un champ manquant ou une affirmation incorrecte.
La documentation Anthropic recommande de fixer des critères mesurables avant d'optimiser : exactitude, cohérence, latence ou pertinence selon l'application. Définir les critères de réussite. Ajoutez vos contraintes métier : format accepté par l'outil suivant, références obligatoires, limites de confidentialité et traitement des demandes impossibles.
Comment mesurer le coût complet ?
Le coût complet inclut les appels initiaux, les reprises, les outils et la correction humaine. Relevez la dépense du fournisseur, le délai total et la raison d'une reprise sur chaque cas. Si un seul cas exige une longue réparation, il doit rester visible dans le rapport plutôt que disparaître dans une moyenne.
Dans un exemple fictif, une équipe prépare des synthèses de dossiers. Le premier palier produit un résumé et les références utilisées. Une validation automatique vérifie leur présence ; le relecteur juge l'exactitude. Les documents incomplets retournent vers leur propriétaire. Appeler Opus sur ces dossiers ne répare pas une source absente.
Séparez les économies de jetons des économies de travail. Un gain d'API ne prouve ni une réduction des effectifs nécessaires ni un meilleur délai de livraison. Notre guide sur les coûts d'inférence aide à distinguer cache, taille de contexte et choix du modèle.
Quelles permissions conserver autour du palier rapide ?
Les permissions suivent l'utilisateur et la tâche, quel que soit le modèle choisi. Le palier rapide ne doit pas recevoir un accès plus large pour compenser ses limites. La récupération documentaire, les secrets et les outils doivent rester contrôlés par l'application.
La documentation Claude Code décrit des permissions granulaires pour les actions de l'agent. Leur disponibilité ne dispense pas de définir la politique de l'entreprise. Permissions Claude Code. Une équipe peut autoriser la lecture d'un dépôt de test, permettre une proposition de modification et réserver la fusion à une revue humaine. L'autorisation d'écrire un fichier ne devient pas une autorisation de publier en production.
Documentez aussi les changements de configuration : version du modèle, effort de raisonnement, prompt et outils. Une variation de ces paramètres rend une comparaison avant/après difficile à interpréter. Le cadre de gouvernance IA fournit le contexte pour attribuer les responsabilités.
Quand faut-il étendre le déploiement ?
L'extension devient raisonnable lorsque le pilote démontre un résultat accepté, des échecs traitables et un retour possible à la configuration précédente. Commencez par une population restreinte et des actions réversibles. Mesurez ce qui se passe après la remise du livrable : une réponse rapide qui ralentit l'étape suivante n'a pas amélioré le processus.
Conservez un journal des escalades. Des erreurs récurrentes sur une même famille de tâches signalent parfois un mauvais routage, parfois une règle de validation absente. Le responsable doit pouvoir modifier l'affectation sans devoir réécrire toute l'application. Cette séparation facilite la migration des outils IA en entreprise.
Questions fréquentes
Sonnet 5.5 remplace-t-il Opus 5.5 ?
Sonnet 5.5 et Opus 5.5 sont positionnés sur des usages différents dans l'annonce Anthropic. Une entreprise peut tester Sonnet sur des travaux délimités et garder un traitement plus approfondi pour les tâches complexes. La décision doit reposer sur ses résultats, pas sur la taille supposée du modèle.
Les 30 % annoncés s'appliquent-ils à notre budget ?
Le chiffre décrit les tests et le périmètre annoncés par l'éditeur. Il ne garantit pas le même gain avec vos prompts, vos documents et vos outils. Le budget doit être mesuré sur un résultat conforme, en incluant les reprises et les corrections humaines.
Faut-il automatiser le routeur dès le premier jour ?
Une affectation explicite par famille de tâches suffit pour commencer. Elle permet d'observer les erreurs avant d'ajouter une décision automatique supplémentaire. Un routeur automatique introduit lui-même des erreurs possibles ; il doit être évalué et pouvoir orienter un cas vers une personne.
Quelle décision prendre maintenant ?
La prochaine décision consiste à choisir une seule tâche et son critère de réussite. Documentez son coût actuel, testez Sonnet 5.5, puis comparez qualité, reprises et délai total. Pour un projet impliquant plusieurs outils, la méthode Noolya permet de cadrer le pilote avant d'étendre le routage.