Claude Opus 5.5 a été annoncé le 22 septembre 2026. Anthropic met en avant un coût d’exécution inférieur à celui d’Opus 5. Pour une entreprise, la décision utile consiste à mesurer combien coûte un résultat accepté, avec les outils, les reprises et la revue humaine. Une baisse du tarif API ne suffit pas à démontrer une économie sur un processus complet.
Cette distinction intéresse particulièrement les équipes qui utilisent un agent pour modifier du code, préparer un dossier ou produire une analyse à partir de documents. Le modèle n’y travaille pas seul : il recherche, recommence, appelle des services et transmet un livrable à quelqu’un. Voici une méthode pour décider si cette nouvelle version mérite une migration sur votre périmètre.
Que change l’annonce du 22 septembre ?
Anthropic présente Opus 5.5 comme une amélioration de performance et d’efficacité. L’entreprise annonce environ 40 % de coût en moins sur ses charges de travail typiques, aux réglages par défaut. Ce chiffre décrit ses évaluations ; il ne constitue pas une réduction garantie de votre facture. Le nombre de tentatives, le cache et le niveau d’effort peuvent modifier le résultat.
Le bon point de départ reste donc votre version actuellement exploitée. Notez son identifiant, ses réglages, ses outils et les critères utilisés pour accepter ses résultats. Si cette référence est mal documentée, une comparaison risque d’attribuer au modèle un gain provenant d’un meilleur prompt ou d’une modification du corpus. Notre analyse de Claude Opus 5 sur les missions complexes permet de replacer cette évolution dans le parcours du produit.
Quel tarif faut-il réellement comparer ?
À la date de l’annonce, Anthropic indique, par million de tokens, 4 dollars en entrée, 20 dollars en sortie et 0,20 dollar en lecture de cache pour Opus 5.5. Les montants comparatifs affichés pour Opus 5 sont 5, 25 et 0,50 dollar. Les tokens d’entrée et de sortie baissent donc de 20 %, tandis que la lecture de cache baisse de 60 %. Ces tarifs et l’économie annoncée de 40 % ne désignent pas la même mesure.
Un exemple fictif aide à comprendre la différence. Pour 400 000 tokens d’entrée non mis en cache, quatre millions lus dans le cache et 60 000 en sortie, le calcul donne 3,60 dollars avec les tarifs indiqués pour Opus 5.5, contre 5,50 dollars pour Opus 5. Le volume est ici strictement identique. Les écritures de cache, outils, taxes et coûts humains sont exclus de cet exemple. Il illustre une méthode de calcul, pas une mesure effectuée sur un client.
Dans votre suivi, séparez les catégories facturées au lieu d’appliquer un tarif moyen à tous les tokens. Conservez aussi le mode utilisé : une option de vitesse ou une plateforme de distribution peut avoir sa propre tarification. Le guide sur l’optimisation des coûts d’inférence explique pourquoi cache, longueur du contexte et choix d’architecture doivent être examinés ensemble.
Comment définir une tâche réussie ?
Une tâche réussie est un résultat qui satisfait des critères fixés avant l’essai. Pour une modification de code, cela peut inclure les tests fonctionnels, l’absence de changement hors périmètre et une revue. Pour une note d’analyse, les critères peuvent porter sur les sources, l’exactitude des chiffres et les informations manquantes correctement signalées. La simple présence d’une réponse ne vaut pas acceptation.
Construisez trois groupes de cas : demandes fréquentes, situations difficiles mais connues et demandes que l’agent doit refuser ou faire clarifier. Utilisez les mêmes dossiers et le même environnement pour les deux versions. Si une réponse dépend d’un service qui change chaque minute, conservez un instantané autorisé ou signalez cette variabilité. Un comparatif dont les entrées diffèrent ne permet pas de localiser la cause d’un écart.
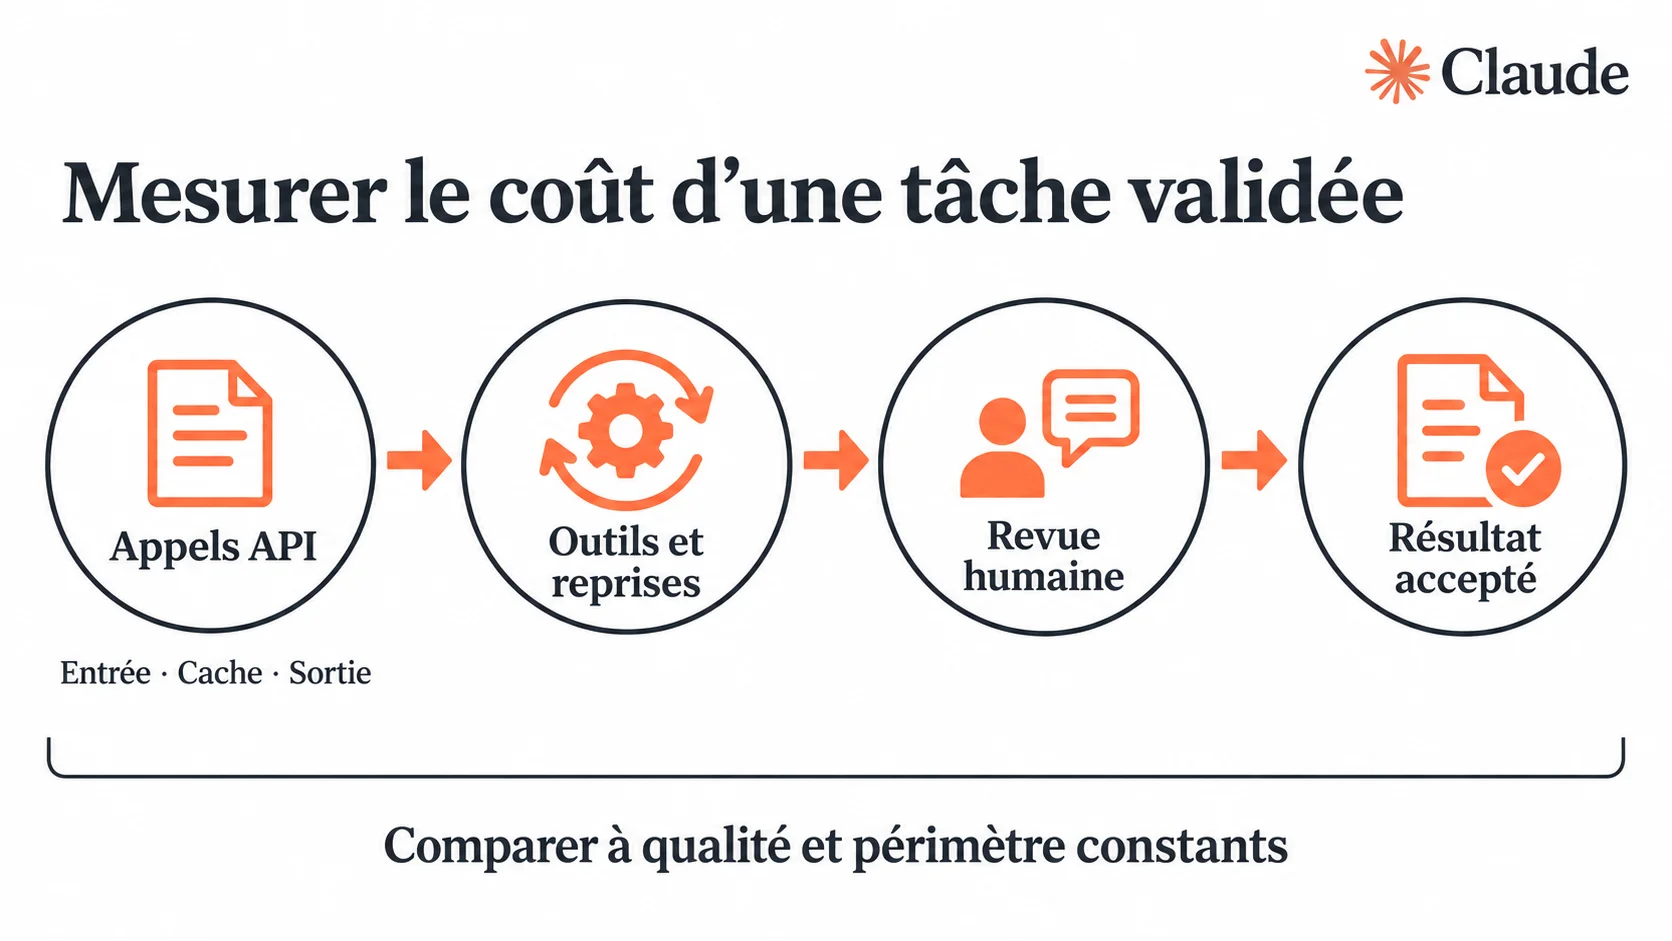
Grille d’analyse Noolya : comparer le coût complet à qualité et périmètre constants. Le schéma ne représente pas un benchmark exécuté.
Quels résultats consigner dans le pilote ?
Pour chaque tâche, enregistrez le verdict, le coût API, les appels d’outils, les tentatives supplémentaires, le délai total et le temps de revue. Ajoutez une catégorie d’échec : mauvaise source, réponse incorrecte, action non autorisée, délai dépassé ou résultat incomplet. Cette classification permet de décider si le problème relève du modèle, de l’intégration ou des données.
Le coût par tâche acceptée peut se calculer en divisant les dépenses du lot par le nombre de résultats acceptés. Ne masquez cependant pas les échecs derrière cette moyenne. Présentez également les effectifs, les cas non terminés et les temps extrêmes. Un modèle moins cher sur la majorité des demandes peut devenir coûteux si quelques cas provoquent de longues boucles ou des reprises manuelles importantes.
La revue humaine doit rester comparable. Si un évaluateur connaît la version qui a produit chaque réponse, ses attentes peuvent influencer son jugement. Lorsque le contexte le permet, présentez les livrables sans leur nom de modèle et utilisez la même grille. Il s’agit d’un dispositif d’évaluation interne, pas d’une promesse de classement universel.
Pourquoi conserver les mêmes permissions ?
Une migration de modèle doit d’abord conserver le périmètre d’action existant. Modifier simultanément le modèle et ses permissions rend les incidents difficiles à attribuer. Commencez avec des outils en lecture seule ou simulés, puis vérifiez séparément les actions qui créent un effet métier. Une meilleure réponse ne dispense pas de contrôler ce qui sera envoyé, modifié ou supprimé.
Le guide pour sécuriser les agents IA distingue les propositions du modèle, les décisions du serveur et les effets réellement exécutés. Rejouez les scénarios de sécurité déjà suivis par votre équipe. Vérifiez aussi que les traces restent exploitables : changer de fournisseur, de SDK ou de format de réponse peut modifier les informations disponibles pour enquêter.
Quand faut-il migrer, attendre ou limiter l’usage ?
Une migration devient défendable lorsque le nouveau modèle respecte vos seuils de qualité et de sécurité tout en améliorant un critère utile : coût, délai, taux de réussite ou effort de revue. Si le gain concerne uniquement une famille de tâches, un routage limité peut suffire. Il n’est pas nécessaire de remplacer partout une version qui répond encore correctement au besoin.
Préparez une décision réversible. Définissez la population du pilote, le responsable de la validation, les signaux de suspension et la version vers laquelle revenir. Un déploiement progressif permet de repérer les différences entre le laboratoire et l’usage réel sans engager immédiatement toutes les équipes. La gouvernance de l’IA fournit le cadre pour enregistrer cette décision et ses limites.
La décision à prendre cette semaine
Sélectionnez un processus suffisamment documenté pour être comparé. Figez un petit lot de tâches représentatives, définissez ce qui compte comme un résultat acceptable et mesurez les deux versions dans les mêmes conditions. Le premier livrable du pilote doit être une décision argumentée, avec ses incertitudes, plutôt qu’un pourcentage d’économie repris d’une annonce.
Opus 5.5 apporte une raison de refaire ce calcul. La valeur pour votre organisation dépendra du travail terminé correctement, des contrôles conservés et du temps réellement récupéré par les équipes.