Une évaluation menée à l’intérieur d’un laboratoire peut observer ce qu’un test externe ne voit pas. Encore faut-il savoir ce que les évaluateurs peuvent examiner, contester et communiquer. Pour une entreprise qui achète un système d’IA, le sujet dépasse le nom du partenaire : il concerne la portée réelle de la preuve reçue.
Le 18 septembre 2026, Anthropic et Accenture ont annoncé une équipe d’évaluation intégrée, conduite par Faculty, au sein d’Anthropic. Le dispositif porte notamment sur l’évaluation, les tests adversariaux et les mécanismes de sécurité. Les annonces décrivent un accès approfondi aux équipes et au processus de développement. Elles ne constituent pas un rapport de résultats sur un modèle précis.
Ce que l’accès interne peut apporter
Un évaluateur externe observe généralement les réponses accessibles par une interface ou une API. Cette approche reste utile : elle reproduit une partie des conditions rencontrées par les utilisateurs. Elle laisse cependant hors champ des choix d’entraînement, des tests internes et certains arbitrages de conception.
Une équipe intégrée peut poser des questions plus tôt. Pourquoi ce scénario a-t-il été exclu ? Que sait-on d’un échec détecté avant la publication ? Quels réglages changent le comportement ? Ces questions n’annulent pas les tests externes. Elles ajoutent une perspective sur la manière dont le système est construit et corrigé.
Les deux annonces précisent que le modèle de fonctionnement doit encore être développé. Elles présentent aussi un financement direct du travail par Anthropic et un partenariat non exclusif. Ces éléments doivent être connus du lecteur. Un financement déclaré ne prouve ni l’absence d’indépendance ni son existence : il invite à examiner les garanties concrètes.
Distinguer proximité et capacité de contradiction
L’accès aux équipes facilite la compréhension. Il peut aussi créer une familiarité avec leurs objectifs et leurs contraintes. Une évaluation robuste doit permettre de conserver un désaccord documenté, même lorsque les personnes travaillent régulièrement ensemble.
Pour qualifier un dispositif, demandez qui choisit les scénarios, qui peut en ajouter et qui décide qu’un échec est clos. Vérifiez l’existence d’une voie d’escalade lorsque l’évaluateur considère un risque insuffisamment traité. Le sujet est organisationnel autant que technique. Un test sévère a peu d’effet si son résultat disparaît dans une synthèse sans responsable.
Notre approche de gouvernance IA consiste à relier chaque décision à une preuve, un périmètre et une personne. Cette logique s’applique à une équipe intégrée comme à une mission externe. Le titre du rapport ne remplace pas la description de ce qui a effectivement été observé.
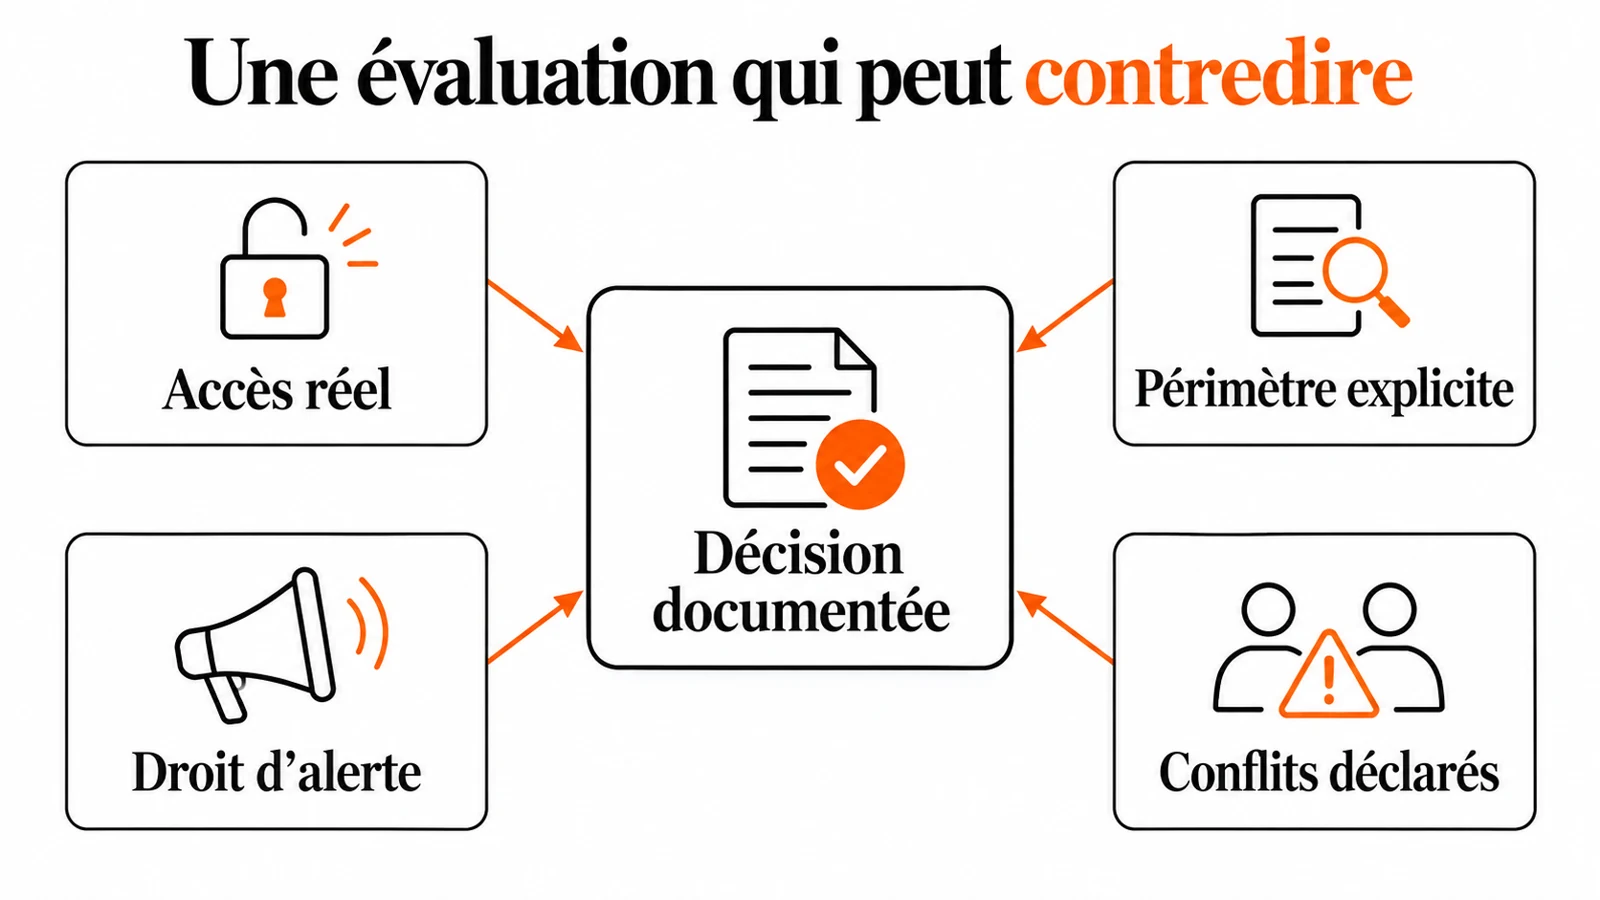
Ces quatre critères constituent une grille de lecture proposée par Noolya. Ils ne décrivent pas des garanties déjà vérifiées dans le partenariat annoncé.
Lire un rapport avant d’en reprendre la conclusion
Un rapport exploitable nomme le système, sa version, ses réglages et les conditions du test. Il distingue les composants examinés de ceux qui restent hors périmètre. Pour un agent, cela inclut les outils disponibles, les droits, les données accessibles et les validations humaines.
La conclusion doit rester attachée à ces conditions. Un modèle testé sans outil ne démontre pas la sécurité d’un agent capable d’envoyer un document. Un résultat obtenu sur des données publiques ne couvre pas automatiquement l’accès à une base interne. Une entreprise peut introduire de nouveaux risques par sa propre intégration.
Dans un audit IA de votre organisation, demandez donc deux niveaux de preuve. Le premier concerne le fournisseur. Le second concerne votre système complet. Les preuves du fournisseur éclairent le choix et les limites. Les tests locaux vérifient les tâches, les autorisations et les mécanismes d’arrêt dont vous êtes responsable.
Évaluer la qualité d’un désaccord
Un désaccord utile contient un scénario reproductible, un effet observé et les conditions qui déclenchent cet effet. Il ne se résume pas à une appréciation comme « trop risqué ». L’équipe chargée du produit doit pouvoir reproduire l’échec et proposer une correction dont l’effet sera retesté.
Prenons un exemple fictif : un assistant de support cite un document auquel le demandeur ne devrait pas avoir accès. L’évaluation doit distinguer la récupération du document, sa présence dans le contexte et sa restitution. Ces étapes orientent des corrections différentes. Le dossier doit aussi conserver les tests qui montrent que les réponses autorisées continuent de fonctionner.
Ce suivi évite une résolution purement cosmétique. Refuser toutes les demandes éliminerait certains incidents tout en détruisant l’utilité du service. Il faut mesurer les violations et la capacité à accomplir la tâche légitime. Les deux séries de résultats doivent rester visibles lors de la décision.
L’analyse d’Anand Candassamy sur Google PageBreak et les preuves de sécurité d’un agent prolonge cette distinction entre signal, reproduction et conclusion. Elle apporte une lecture technique complémentaire au cadre d’évaluation présenté ici.
Prévoir ce qui peut être communiqué
La transparence ne consiste pas à publier chaque détail d’une vulnérabilité immédiatement. Certains éléments pourraient faciliter son exploitation. Elle suppose toutefois de décrire le périmètre du travail, ses limites et la manière dont les problèmes sont traités.
Avant de retenir une évaluation comme preuve, identifiez les droits de publication, les restrictions de confidentialité et le traitement des désaccords persistants. Une synthèse publique peut être accompagnée d’un dossier plus détaillé réservé aux interlocuteurs autorisés. Les limites de diffusion doivent être explicites, afin que le lecteur sache ce qu’il ne peut pas vérifier.
Le Research Lab Noolya privilégie cette distinction entre annonce, protocole et résultat. Une annonce révèle une intention et une organisation. Un protocole explique comment l’examiner. Un résultat décrit ce qui a été observé dans des conditions précises. Confondre ces trois niveaux produit une confiance que les données ne justifient pas encore.
Traduire la grille dans un appel d’offres
Demandez un exemple anonymisé de constat, la méthode de sélection des scénarios et la procédure de retest. Exigez une description des dépendances : accès fournis par le client, durée disponible, versions testées et composants exclus. Ces éléments rendent les offres comparables sans réduire l’évaluation à un nombre de tests.
Précisez aussi les critères d’acceptation de la mission. Le livrable doit permettre à votre équipe de reproduire les constats pertinents et de suivre les corrections. Un score global seul ne remplit pas cette fonction. Il peut aider à suivre une tendance, mais il ne remplace pas la liste des échecs critiques.
Enfin, conservez la responsabilité de la décision de déploiement. Un prestataire apporte une expertise et des preuves. Il ne connaît pas nécessairement toutes les conséquences de votre usage. Le décideur doit pouvoir expliquer les risques acceptés, les limites imposées et les raisons d’une éventuelle suspension.
Questions fréquentes
Une évaluation intégrée remplace-t-elle un audit externe ?
Pas automatiquement. L’accès interne et le regard externe répondent à des questions différentes. Leur complémentarité dépend du périmètre, des droits d’accès et des mécanismes de contradiction.
Le financement par le fournisseur invalide-t-il le travail ?
Non, pas à lui seul. Il faut examiner les conflits déclarés, la liberté de choisir les tests, la gestion des désaccords et les possibilités de communication des résultats.
Que doit vérifier l’entreprise utilisatrice ?
Son propre système : données, outils, droits, tâches et supervision. Une évaluation du modèle ne couvre pas automatiquement les risques ajoutés par l’intégration.
Sources
- Anthropic, annonce de l’équipe d’évaluation intégrée, 18 septembre 2026.
- Accenture, présentation officielle du partenariat, 18 septembre 2026.
- NIST, AI Risk Management Framework.
La grille d’analyse de cet article est une proposition méthodologique. Noolya n’a pas audité le dispositif annoncé et ne conclut pas sur son efficacité future.